<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <id>https://acoolfish.site/</id>
  <title type="text">ACoolBlog</title>
  <subtitle type="text">多模态 · Agent · 强化学习 | 学习笔记</subtitle>
  <updated>2026-11-15T00:00:00.000Z</updated>
  <author><name>ACoolBlog</name></author>
  <link rel="alternate" href="https://acoolfish.site/"/>
  <link rel="self" href="https://acoolfish.site/atom.xml"/>
  <generator uri="https://github.com/CuteLeaf/Firefly">Firefly v6.16.9</generator>
    <entry>
      <id>https://acoolfish.site/posts/data-formats-mixed-precision/</id>
      <title type="text">浅解大模型训练中的数据格式与混合精度</title>
      <published>2026-11-15T00:00:00.000Z</published>
      <updated>2026-11-15T00:00:00.000Z</updated>
      <author><name>ACoolBlog</name></author>
      <link rel="alternate" href="https://acoolfish.site/posts/data-formats-mixed-precision/"/>
      <summary type="text">FP16/BF16/FP8 的取舍、为什么 BF16 赢得训练而 FP16 退守推理，以及 AMP 混合精度训练的显存拆账。</summary>
      <content type="html"><![CDATA[<p>大模型训练推理中各种数据格式其实就是不同类型的浮点数，而一个浮点数由三部分组成，从高位到低位依次是：</p>
<div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>┌───────────────┬──────────────────────────┬─────────────────────────────────┐</span></div></div><div><div><div>2</div></div><div><span>│  符号位 (S)    │        指数位 (E)         │           尾数位 (M)             │</span></div></div><div><div><div>3</div></div><div><span>│     1 bit     │          E bits          │             M bits             │</span></div></div><div><div><div>4</div></div><div><span>└───────┬───────┴────────────┬─────────────┴────────────────┬────────────────┘</span></div></div><div><div><div>5</div></div><div><span><span>        </span></span><span>│                    │                              │</span></div></div><div><div><div>6</div></div><div><span><span>        </span></span><span>│                    │                              └── 决定「数值精度」 (有效数字多少)</span></div></div><div><div><div>7</div></div><div><span><span>        </span></span><span>│                    └───────────────────────────────── 决定「动态范围」 (最大/最小值跨度)</span></div></div><div><div><div>8</div></div><div><span><span>        </span></span><span>└──────────────────────────────────────────────────── 决定「正负符号」 (0 为正, 1 为负)</span></div></div></code></pre><div><div></div><div></div></div></figure></div>
<p>而不同数据格式的区别见下表：</p>

<table><thead><tr><th>格式</th><th>总 bits</th><th>符号 S</th><th>指数 E</th><th>尾数 M</th><th>最大值</th><th>精度</th><th>典型用途</th></tr></thead><tbody><tr><td>FP32</td><td>32</td><td>1</td><td>8</td><td>23</td><td>3.4e38</td><td>高（7位十进制）</td><td>基准测试/调试/优化器主权重</td></tr><tr><td>FP16</td><td>16</td><td>1</td><td>5</td><td>10</td><td>≈65504</td><td>中（3位十进制）</td><td>推理加速（TensorRT/vLLM）</td></tr><tr><td>BF16</td><td>16</td><td>1</td><td>8</td><td>7</td><td>3.4e38</td><td>中低（2位十进制）</td><td>大模型训练主流（A100/H100/TPU）</td></tr><tr><td>FP8-E4M3</td><td>8</td><td>1</td><td>4</td><td>3</td><td>小</td><td>低</td><td>H100 前向传播 / 激活值量化</td></tr><tr><td>FP8-E5M2</td><td>8</td><td>1</td><td>5</td><td>2</td><td>中</td><td>极低</td><td>H100 反向传播 / 梯度量化</td></tr><tr><td>INT8</td><td>8</td><td>—</td><td>—</td><td>—</td><td>[-128,127]</td><td>靠缩放</td><td>量化推理</td></tr><tr><td>INT4</td><td>4</td><td>—</td><td>—</td><td>—</td><td>[-8,7]</td><td>极靠缩放</td><td>LLM 权重量化</td></tr></tbody></table>
<blockquote><p>指数位越大，该数据格式能表示的数值范围越大，训练时可以很好的避免数值上溢的问题。尾数位越大，这种数据格式可以表示的小数有效数字越多，表示的数值精度越大。</p></blockquote>
<section><h2><strong>通过一个问题进一步了解 FP16 与 BF16。</strong><a href="#通过一个问题进一步了解-fp16-与-bf16"><span>#</span></a></h2><section><h4>为什么现代大模型预训练（如 LLaMA）大多转向了 BF16，而不再首选 FP16？<a href="#为什么现代大模型预训练如-llama大多转向了-bf16而不再首选-fp16"><span>#</span></a></h4><p>FP16 指数位为 5，尾数位是 10，他能表示的数值最大值有限（最大为 65504），在大模型训练中会出现以下两个问题：</p><ul>
<li><strong>上溢问题（主要痛点）</strong>：Attention 的 logits、未归一化的激活值、或某些层的梯度容易超过 65504，造成上溢变成 <code>NaN</code>，一旦出现 <code>NaN</code>，会立即传播到整个模型，导致训练崩溃。这是 FP16 训练的<strong>最大障碍</strong>。</li>
<li><strong>下溢问题（次要）</strong>：反向传播中的小梯度（如 10⁻⁷ 量级）可能因精度不足被截断，影响参数更新。</li>
</ul><blockquote><p>为了解决 FP16 带来的问题，这时候就需要进行工程上的优化，引入 <strong>Loss Scaling（损失缩放）</strong>：</p><ul>
<li><strong>原理</strong>：在反向传播前放大损失值（如乘以 1024），将小梯度放大到 FP16 可表示范围，计算完成后再缩小回来，从而缓解下溢。</li>
<li><strong>局限</strong>：只能解决梯度的下溢，无法解决前向传播中的上溢；且缩放因子需要动态调整（检测溢出后减小，长期无溢出时增大），增加了工程复杂度。</li>
<li><strong>历史成功</strong>：早期的 BERT、GPT-2 等模型在 V100（仅支持 FP16 Tensor Core）上通过精心调优仍实现了稳定训练。</li>
</ul></blockquote><p>由于 FP16 的数据格式训练太麻烦，<strong>BF16 就诞生了</strong>，它的指数位为 8，尾数位是 7，这样它能<strong>像 FP32 那样表示很大的数值范围，<span><span>3.4×10383.4 \times 10^{38}</span><span><span><span></span><span>3.4</span><span></span><span>×</span><span></span></span><span><span></span><span>1</span><span><span>0</span><span><span><span><span><span><span></span><span><span><span>38</span></span></span></span></span></span></span></span></span></span></span></span></strong>，在实际<strong>训练中几乎不会上溢</strong>——这是相比 FP16 的决定性优势。而 BF16 损失的数值精度微不足道，因为训练是长期累积的统计过程，<strong>单步的微小舍入误差会被后续更新”平滑”掉</strong>。</p><p><strong>所以，用较小的精度代价换取极大的数值稳定性，BF16 成为了现代大模型预训练（如 LLaMA、GPT-3、PaLM）的主流选择。</strong></p><p>此外，A100 起原生支持 BF16 Tensor Core。</p></section></section>
<section><h2>FP8 的出现 —— NVIDIA H100（Hopper 架构）专属<a href="#fp8-的出现--nvidia-h100hopper-架构专属"><span>#</span></a></h2><p>随着模型越来越大，16-bit 已经满足不了工业界的胃口了。NVIDIA 在 H100 中引入了极其激进的原生 FP8 计算。它仅在 8 bits 空间努力同时兼顾范围和精度 → 拆成两种独立变体，训练时前向传播与后向传播各用一个：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span><span>        </span></span><span>前向/激活 (E4M3)              反向/梯度 (E5M2)</span></div></div><div><div><div>2</div></div><div><span><span>   </span></span><span>┌─┬─────────┬─────────┐      ┌─┬───────────┬───────┐</span></div></div><div><div><div>3</div></div><div><span><span>   </span></span><span>│S│E(4 bits)│M(3 bits)│      │S│E(5 bits)  │M(2位) │</span></div></div><div><div><div>4</div></div><div><span><span>   </span></span><span>└─┴─────────┴─────────┘      └─┴───────────┴───────┘</span></div></div><div><div><div>5</div></div><div><span><span>    </span></span><span>侧重：精度（尾数多1位）         侧重：范围（指数多1位）</span></div></div><div><div><div>6</div></div><div><span><span>    </span></span><span>激活值分布集中，要精度          梯度跨度极大，怕下溢</span></div></div></code></pre><div><div></div><div></div></div></figure></div><ul>
<li>
<p><strong>E4M3（前向/激活）</strong>：指数 4 位 + 尾数 3 位。前向对精度敏感，激活值分布集中不需要大范围</p>
</li>
<li>
<p><strong>E5M2（反向/梯度）</strong>：指数 5 位 + 尾数 2 位。反向梯度跨度极大，必须多给指数位防下溢</p>
</li>
<li>
<p><strong>优势</strong>：显存再减半（相对 16-bit），算力进一步提升</p>
</li>
<li>
<p><strong>当前状态</strong>：H100 硬件支持，但生态还在成熟中；训练时混合精度从 BF16 → FP8 的门槛较高（需要 careful scaling）</p>
</li>
</ul><hr /></section>
<section><h2>混合精度训练 (AMP, Automatic Mixed Precision)<a href="#混合精度训练-amp-automatic-mixed-precision"><span>#</span></a></h2><section><h3>1 什么是混合精度训练<a href="#1-什么是混合精度训练"><span>#</span></a></h3><p>一句话：<strong>前向和反向用 16-bit（FP16/BF16）省显存 + 加速，参数更新用 FP32 保精度。</strong></p><div><div><div><div><span></span></div><div><span></span></div><div><span></span></div><div><span></span></div><div><span></span></div><div><span></span></div><div><span></span></div><div><span><p>下一轮</p></span></div><div><span><p>输入 x (FP16/BF16)</p></span></div><div><span><p>Forward (16-bit)<br /><br />Tensor Core 加速</p></span></div><div><span><p>Loss (16-bit)<br /><br />⚠️ FP16需Loss Scaling</p></span></div><div><span><p>Backward (16-bit)</p></span></div><div><span><p>梯度 ∇W (16-bit)</p></span></div><div><span><p>梯度转 FP32</p></span></div><div><span><p>Optimizer Step (FP32)<br /><br />• Master权重<br /><br />• Adam动量<br /><br />• W_new = W_old - LR×∇W</p></span></div><div><span><p>强转回 16-bit</p></span></div>
</div><div><div><span></span></div><div><span></span></div><div><span></span></div><div><span></span></div><div><span></span></div><div><span></span></div><div><span></span></div><div><span><p>下一轮</p></span></div><div><span><p>输入 x (FP16/BF16)</p></span></div><div><span><p>Forward (16-bit)<br /><br />Tensor Core 加速</p></span></div><div><span><p>Loss (16-bit)<br /><br />⚠️ FP16需Loss Scaling</p></span></div><div><span><p>Backward (16-bit)</p></span></div><div><span><p>梯度 ∇W (16-bit)</p></span></div><div><span><p>梯度转 FP32</p></span></div><div><span><p>Optimizer Step (FP32)<br /><br />• Master权重<br /><br />• Adam动量<br /><br />• W_new = W_old - LR×∇W</p></span></div><div><span><p>强转回 16-bit</p></span></div>
</div></div></div></section><section><h3>2 为什么优化器必须保留 FP32 Master Weights？<a href="#2-为什么优化器必须保留-fp32-master-weights"><span>#</span></a></h3><p><strong>核心公式</strong>：参数更新步 <code>W_new = W_old - LR × ∇W</code></p><p>训练后期学习率非常小（例如 <code>10⁻⁵</code> 量级），梯度 <code>∇W</code> 也很小，两者乘出来的更新量 <code>ΔW = LR × ∇W</code> 是一个<strong>极其微小的数</strong>。</p><p>假设 <code>W_old = 1.0</code>，<code>ΔW = 10⁻⁷</code>：</p>

<table><thead><tr><th>精度</th><th><code>1.0 + 1e-7</code> 的结果</th><th>能不能吃进更新？</th></tr></thead><tbody><tr><td>FP32（23 位尾数）</td><td><code>1.0000001</code> ✓</td><td>能，23 位尾数足够识别微小增量</td></tr><tr><td>BF16（7 位尾数）</td><td><code>1.0</code> ❌</td><td><strong>精度不足被抹零！</strong></td></tr><tr><td>FP16（10 位尾数）</td><td><code>1.0</code> ❌</td><td><strong>精度不足被抹零！</strong></td></tr></tbody></table><p>如果优化器也用 16-bit 存权重，微小更新直接归零，模型<strong>彻底停止学习</strong>。所以必须存一份 FP32 的 Master Weights 来做参数累加，再截断回 16-bit 做前向。</p></section><section><h3>3 混合精度训练的显存拆分（Adam 优化器）<a href="#3-混合精度训练的显存拆分adam-优化器"><span>#</span></a></h3><p>设模型参数量为 Φ（单位 B）：</p>

<table><thead><tr><th>组件</th><th>精度</th><th>字节数/参数</th><th>小计（GB）</th><th>占比</th></tr></thead><tbody><tr><td>模型参数（Forward 用）</td><td>FP16 / BF16</td><td>2</td><td>2Φ</td><td>12.5%</td></tr><tr><td>梯度（Backward 结果）</td><td>FP16 / BF16</td><td>2</td><td>2Φ</td><td>12.5%</td></tr><tr><td>FP32 主权重（Master）</td><td>FP32</td><td>4</td><td>4Φ</td><td>25.0%</td></tr><tr><td>Adam 一阶动量 (m)</td><td>FP32</td><td>4</td><td>4Φ</td><td>25.0%</td></tr><tr><td>Adam 二阶动量 (v)</td><td>FP32</td><td>4</td><td>4Φ</td><td>25.0%</td></tr><tr><td><strong>总计</strong></td><td></td><td></td><td><strong>16Φ</strong></td><td><strong>100%</strong></td></tr></tbody></table><blockquote><p>SGD 优化器没有二阶动量，优化器状态只需 4Φ，总显存 = 2Φ + 2Φ + 4Φ = <strong>8Φ</strong></p></blockquote><p><strong>结论</strong>：优化器状态占据了 75% 的训练显存！这就是为什么同样一张卡，推理能跑的模型比训练大得多——推理不需要优化器状态。</p><p>最后一个小总结：</p><section><h5>BF16 的三大优势<a href="#bf16-的三大优势"><span>#</span></a></h5><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>BF16 为什么赢？</span></div></div><div><div><div>2</div></div><div><span>├── ① 范围大（8位指数=FP32级）→ 实际训练几乎不上溢</span></div></div><div><div><div>3</div></div><div><span>├── ② 零调参（不用 Loss Scaling）→ 工程师幸福指数翻倍</span></div></div><div><div><div>4</div></div><div><span>└── ③ 硬件成主流（A100 起原生 BF16 Tensor Core）→ 算力不打折</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>精度损失（少 3 位尾数）的代价几乎可以忽略——神经网络对单步误差鲁棒，而溢出是灾难性的。用 3 位尾数的代价换永不崩溃，这笔交易在 LLaMA 时代绝对划算。</p></section><section><h5>FP16 没被淘汰，只是换了战场<a href="#fp16-没被淘汰只是换了战场"><span>#</span></a></h5><ul>
<li><strong>训练</strong>：BF16 全面胜出</li>
<li><strong>推理</strong>：FP16 仍是优选
<ul>
<li>推理不涉及梯度和参数更新，数值范围压力小</li>
<li>FP16 10 位尾数 &gt; BF16 7 位尾数 → 推理输出质量略好</li>
<li>很多推理框架（TensorRT / vLLM）默认 FP16</li>
</ul>
</li>
</ul><hr /></section></section></section>
<section><h2>附：硬件演进时间线（数据精度视角）<a href="#附硬件演进时间线数据精度视角"><span>#</span></a></h2>

<table><thead><tr><th>代际</th><th>架构</th><th>GPU 代表</th><th>关键精度升级</th></tr></thead><tbody><tr><td>2017</td><td>Volta</td><td>V100</td><td>FP16 Tensor Core（FP16 时代开启）</td></tr><tr><td>2020</td><td>Ampere</td><td><strong>A100</strong></td><td><strong>BF16 原生 + TF32 隐形加速（大模型时代基石）</strong></td></tr><tr><td>2022</td><td>Ada Lovelace</td><td>RTX 4090</td><td>FP8 推理支持</td></tr><tr><td>2022</td><td>Hopper</td><td><strong>H100</strong></td><td><strong>FP8 E4M3 + E5M2 双变体原生训练（极致效率）</strong></td></tr></tbody></table></section>]]></content>
    </entry>
    <entry>
      <id>https://acoolfish.site/posts/decoding-and-speculative/</id>
      <title type="text">浅解码码策略与投机解码</title>
      <published>2026-11-15T00:00:00.000Z</published>
      <updated>2026-11-15T00:00:00.000Z</updated>
      <author><name>ACoolBlog</name></author>
      <link rel="alternate" href="https://acoolfish.site/posts/decoding-and-speculative/"/>
      <summary type="text">从 logits 到 token 的解码策略（Temperature / Top-K / Top-p）与投机解码的草稿-验证机制、接受概率公式与无损保证。</summary>
      <content type="html"><![CDATA[<section><h2>一、解码策略：从 logits 到 token<a href="#一解码策略从-logits-到-token"><span>#</span></a></h2><section><h3>1.1 核心问题<a href="#11-核心问题"><span>#</span></a></h3><p>模型输出的是整张词表的 logits（形状 <code>[vocab_size]</code>，如 32000 个数），怎么把它变成下一个 token？</p><ul>
<li>
<p>永远选最高分（Greedy）→ 输出死板、重复</p>
</li>
<li>
<p>完全随机采样 → 容易失控、胡言乱语</p>
</li>
</ul><p>解码策略要做的，就是在”确定性”和”多样性”之间设定一套可控规则。</p></section><section><h3>1.2 三个核心策略<a href="#12-三个核心策略"><span>#</span></a></h3>

<table><thead><tr><th>策略</th><th>公式</th><th>作用</th><th>直觉</th></tr></thead><tbody><tr><td><strong>Temperature</strong></td><td><code>logits / T</code></td><td>调分布形状</td><td>T&lt;1 变尖锐（更确定），T&gt;1 变平缓（更随机）</td></tr><tr><td><strong>Top-K</strong></td><td>保留分数最高的 K 个</td><td>固定数量截断</td><td>其余 logits 置 −∞，不管分布形状</td></tr><tr><td><strong>Top-p (Nucleus)</strong></td><td>累积概率超过 p 即截断</td><td>动态截断</td><td>分布尖锐时少留，平缓时多留</td></tr></tbody></table><p><strong>区别：</strong> Top-K 是固定数量，Top-p 是动态数量——后者能根据分布形状自适应。</p></section><section><h3>1.3 解码流程<a href="#13-解码流程"><span>#</span></a></h3><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>Logits → Temperature → Top-K → Top-p → Softmax 重归一化 → Multinomial 采样 → next token</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>顺序不能乱：<strong>温度调节影响分布形状，必须在截断之前做</strong>。通常先 K 后 p。</p></section><section><h3>1.4 Top-p 实现难点<a href="#14-top-p-实现难点"><span>#</span></a></h3><p>以词表 5 个词、概率 <code>[0.5, 0.3, 0.1, 0.05, 0.05]</code>、阈值 p=0.85 为例：</p><ol>
<li>降序排序，记住原始索引</li>
<li>算 softmax 得概率，再算 cumsum：<code>[0.5, 0.8, 0.9, 0.95, 1.0]</code></li>
<li>找超过 0.85 的位置：<code>[False, False, True, True, True]</code></li>
<li><strong>向右平移一位</strong>：保留第一个超过阈值的 token，掩码变 <code>[False, False, False, True, True]</code></li>
<li>对应位置 logits 置 −∞</li>
<li><code>scatter_</code> 恢复原始索引顺序</li>
</ol><blockquote><p><strong>为什么要平移？</strong> 累加和刚超过 p 的那个 token 是”刚好够”的临界点，必须保留，否则核会变小导致采样失真。</p></blockquote></section><section><h3>1.5 代码参考<a href="#15-代码参考"><span>#</span></a></h3><div><div><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>def</span><span> </span><span>apply_temperature</span><span>(</span><span>logits</span><span>,</span><span><span> </span><span>temperature</span></span><span>):</span></div></div><div><div><div>2</div></div><div><span><span>    </span></span><span>temp </span><span>=</span><span> </span><span>max</span><span>(temperature, </span><span>1e-6</span><span>)  </span><span># 防除零</span></div></div><div><div><div>3</div></div><div><span>    </span><span>return</span><span><span> logits </span><span>/</span><span> temp</span></span></div></div><div><div><div>4</div></div><div>
</div></div><div><div><div>5</div></div><div><span>def</span><span> </span><span>apply_top_k</span><span>(</span><span>logits</span><span>,</span><span><span> </span><span>top_k</span></span><span>):</span></div></div><div><div><div>6</div></div><div><span>    </span><span>if</span><span><span> top_k </span><span>&lt;=</span><span> </span></span><span>0</span><span> </span><span>or</span><span><span> top_k </span><span>&gt;=</span><span> logits.</span><span>size</span><span>(</span><span>-</span></span><span>1</span><span>):</span></div></div><div><div><div>7</div></div><div><span>        </span><span>return</span><span> logits</span></div></div><div><div><div>8</div></div><div><span><span>    </span></span><span>kth_values, _ </span><span>=</span><span> torch.</span><span>topk</span><span>(logits, top_k, </span><span>dim</span><span>=-</span><span>1</span><span>, </span><span>largest</span><span>=</span><span>True</span><span>, </span><span>sorted</span><span>=</span><span>True</span><span>)</span></div></div><div><div><div>9</div></div><div><span><span>    </span></span><span>kth_values </span><span>=</span><span> kth_values[</span><span>...</span><span>, </span><span>-</span><span>1</span><span>:]  </span><span># 第 K 大的值</span></div></div><div><div><div>10</div></div><div><span>    </span><span>return</span><span><span> torch.</span><span>where</span><span>(logits </span><span>&lt;</span><span> kth_values, torch.</span><span>tensor</span><span>(</span></span><span>float</span><span>(</span><span>'-inf'</span><span>)), logits)</span></div></div><div><div><div>11</div></div><div>
</div></div><div><div><div>12</div></div><div><span>def</span><span> </span><span>apply_top_p</span><span>(</span><span>logits</span><span>,</span><span><span> </span><span>top_p</span></span><span>):</span></div></div><div><div><div>13</div></div><div><span>    </span><span>if</span><span><span> top_p </span><span>&lt;=</span><span> </span></span><span>0.0</span><span> </span><span>or</span><span><span> top_p </span><span>&gt;=</span><span> </span></span><span>1.0</span><span>:</span></div></div><div><div><div>14</div></div><div><span>        </span><span>return</span><span> logits</span></div></div><div><div><div>15</div></div><div><span><span>    </span></span><span>sorted_logits, sorted_indices </span><span>=</span><span> torch.</span><span>sort</span><span>(logits, </span><span>descending</span><span>=</span><span>True</span><span>)</span></div></div><div><div><div>16</div></div><div><span><span>    </span></span><span>cumulative_probs </span><span>=</span><span> torch.</span><span>cumsum</span><span>(F.</span><span>softmax</span><span>(sorted_logits, </span><span>dim</span><span>=-</span><span>1</span><span>), </span><span>dim</span><span>=-</span><span>1</span><span>)</span></div></div><div><div><div>17</div></div><div><span><span>    </span></span><span>sorted_indices_to_remove </span><span>=</span><span> cumulative_probs </span><span>&gt;</span><span> top_p</span></div></div><div><div><div>18</div></div><div><span>    </span><span># 向右平移，保留临界 token</span></div></div><div><div><div>19</div></div><div><span><span>    </span></span><span>sorted_indices_to_remove[</span><span>...</span><span>, </span><span>1</span><span><span>:] </span><span>=</span><span> sorted_indices_to_remove[</span><span>...</span><span>, :</span><span>-</span></span><span>1</span><span><span>].</span><span>clone</span><span>()</span></span></div></div><div><div><div>20</div></div><div><span><span>    </span></span><span>sorted_indices_to_remove[</span><span>...</span><span>, </span><span>0</span><span><span>] </span><span>=</span><span> </span></span><span>0</span></div></div><div><div><div>21</div></div><div><span><span>    </span></span><span>sorted_logits[sorted_indices_to_remove] </span><span>=</span><span> </span><span>float</span><span>(</span><span>'-inf'</span><span>)</span></div></div><div><div><div>22</div></div><div><span>    </span><span>return</span><span><span> torch.</span><span>zeros_like</span><span>(logits).</span><span>scatter_</span><span>(</span></span><span>dim</span><span>=-</span><span>1</span><span>, </span><span>index</span><span><span>=</span><span>sorted_indices, </span></span><span>src</span><span><span>=</span><span>sorted_logits)</span></span></div></div><div><div><div>23</div></div><div>
</div></div><div><div><div>24</div></div><div><span>def</span><span> </span><span>decode_next_token</span><span>(</span><span>logits</span><span>,</span><span><span> </span><span>temperature</span></span><span>=</span><span>0.7</span><span>,</span><span><span> </span><span>top_k</span></span><span>=</span><span>50</span><span>,</span><span><span> </span><span>top_p</span></span><span>=</span><span>0.9</span><span>):</span></div></div><div><div><div>25</div></div><div><span><span>    </span></span><span>logits </span><span>=</span><span> </span><span>apply_temperature</span><span>(logits, temperature)</span></div></div><div><div><div>26</div></div><div><span><span>    </span></span><span>logits </span><span>=</span><span> </span><span>apply_top_k</span><span>(logits, top_k)</span></div></div><div><div><div>27</div></div><div><span><span>    </span></span><span>logits </span><span>=</span><span> </span><span>apply_top_p</span><span>(logits, top_p)</span></div></div><div><div><div>28</div></div><div><span><span>    </span></span><span>probs </span><span>=</span><span> F.</span><span>softmax</span><span>(logits, </span><span>dim</span><span>=-</span><span>1</span><span>)</span></div></div><div><div><div>29</div></div><div><span>    </span><span>return</span><span><span> torch.</span><span>multinomial</span><span>(probs, </span></span><span>num_samples</span><span>=</span><span>1</span><span>)</span></div></div></code></pre><div><div></div><div></div></div></figure><div></div></div><span>展开</span><span>收起</span></div></div><hr /></section></section>
<section><h2>二、投机解码：减少大模型逐 token 调用<a href="#二投机解码减少大模型逐-token-调用"><span>#</span></a></h2><section><h3>2.1 核心问题<a href="#21-核心问题"><span>#</span></a></h3><p>自回归生成最慢的地方，不是一次前向有多复杂，而是大模型必须<strong>一个 token 一个 token 串行走</strong>。前面 Flash Attention 和 PagedAttention 解决了”单次更快/更省显存”，投机解码走另一条路：<strong>能不能先让小模型多猜几步，再由大模型一次性并行验证？</strong></p></section><section><h3>2.2 核心机制：草稿-验证<a href="#22-核心机制草稿-验证"><span>#</span></a></h3><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>Draft Model（小）→ 候选序列 x₁,x₂,...,x_K → Target Model（大）并行验证 → 接受-拒绝逐个判定</span></div></div></code></pre><div><div></div><div></div></div></figure></div><ul>
<li>
<p><strong>草稿模型</strong>：小而快，先自回归猜 K 个 token</p>
</li>
<li>
<p><strong>目标模型</strong>：大而准，对这 K 个位置一次性并行算出概率</p>
</li>
<li>
<p><strong>验证循环</strong>：逐个比较 p(x) 和 q(x)，能接受就连续前进，拒绝时立刻 break</p>
</li>
</ul></section><section><h3>2.3 接受概率公式（核心）<a href="#23-接受概率公式核心"><span>#</span></a></h3><p><span><span>α(x)=min⁡(1,p(x)q(x))\alpha(x) = \min\left(1, \frac{p(x)}{q(x)}\right)</span><span><span><span></span><span>α</span><span>(</span><span>x</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span>min</span><span></span><span><span><span>(</span></span><span>1</span><span>,</span><span></span><span><span></span><span><span><span><span><span><span></span><span><span><span>q</span><span>(</span><span>x</span><span>)</span></span></span></span><span><span></span><span></span></span><span><span></span><span><span><span>p</span><span>(</span><span>x</span><span>)</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span></span><span><span>)</span></span></span></span></span></span></p><ul>
<li><code>p(x)</code>：大模型概率，<code>q(x)</code>：小模型概率</li>
</ul>

<table><thead><tr><th>情况</th><th>条件</th><th>接受概率</th><th>行为</th></tr></thead><tbody><tr><td><strong>A：必接受</strong></td><td>p ≥ q</td><td>α = 1</td><td>大模型认为 token 足够合理，直接接受，不用掷硬币</td></tr><tr><td><strong>B：按概率接受</strong></td><td>p &lt; q</td><td>α = p/q &lt; 1</td><td>小模型过于激进，掷硬币决定；拒绝则立刻 break</td></tr></tbody></table><p><strong>为什么 B 要校正：</strong> 小模型概率 q 偏高（它觉得这个 token 很可能），但大模型概率 p 偏低（大模型觉得不太可能）。直接接受会把小模型的偏差带进来，所以用 p/q 压低接受率。</p></section><section><h3>2.4 为什么无损<a href="#24-为什么无损"><span>#</span></a></h3><p>拒绝时停止草稿链，交还大模型重新采样。最终输出分布 = 纯大模型自回归生成，<strong>数学上严格等价</strong>。</p><blockquote><p><strong>关键约束：</strong> 后续草稿 token 都建立在前缀被接受的前提上。一旦某个 token 被拒绝，后面猜的全作废——这是”带终止条件的接受-拒绝采样”。</p></blockquote></section><section><h3>2.5 代码参考<a href="#25-代码参考"><span>#</span></a></h3><div><div><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>def</span><span> </span><span>speculative_verify</span><span>(</span><span>draft_probs</span><span>,</span><span><span> </span><span>target_probs</span></span><span>,</span><span><span> </span><span>draft_tokens</span></span><span>):</span></div></div><div><div><div>2</div></div><div><span>    </span><span>"""</span></div></div><div><div><div>3</div></div><div><span><span>    </span></span><span>draft_probs:    小模型概率 [K, vocab_size]</span></div></div><div><div><div>4</div></div><div><span><span>    </span></span><span>target_probs:   大模型概率 [K, vocab_size]</span></div></div><div><div><div>5</div></div><div><span><span>    </span></span><span>draft_tokens:   小模型采样的 K 个 token_id</span></div></div><div><div><div>6</div></div><div><span><span>    </span></span><span>返回: 被接受的 token 列表</span></div></div><div><div><div>7</div></div><div><span><span>    </span></span><span>"""</span></div></div><div><div><div>8</div></div><div><span><span>    </span></span><span>accepted_tokens </span><span>=</span><span> []</span></div></div><div><div><div>9</div></div><div><span>    </span><span>for</span><span> i </span><span>in</span><span> </span><span>range</span><span>(</span><span>len</span><span>(draft_tokens)):</span></div></div><div><div><div>10</div></div><div><span><span>        </span></span><span>token_id </span><span>=</span><span> draft_tokens[i]</span></div></div><div><div><div>11</div></div><div><span><span>        </span></span><span>p </span><span>=</span><span> target_probs[i, token_id].</span><span>item</span><span>()</span></div></div><div><div><div>12</div></div><div><span><span>        </span></span><span>q </span><span>=</span><span> draft_probs[i, token_id].</span><span>item</span><span>()</span></div></div><div><div><div>13</div></div><div>
</div></div><div><div><div>14</div></div><div><span>        </span><span>if</span><span><span> p </span><span>&gt;=</span><span> q:</span></span></div></div><div><div><div>15</div></div><div><span>            </span><span># 情况 A：必接受</span></div></div><div><div><div>16</div></div><div><span><span>            </span></span><span>accepted_tokens.</span><span>append</span><span>(token_id)</span></div></div><div><div><div>17</div></div><div><span>        </span><span>else</span><span>:</span></div></div><div><div><div>18</div></div><div><span>            </span><span># 情况 B：按 p/q 掷硬币</span></div></div><div><div><div>19</div></div><div><span><span>            </span></span><span>r </span><span>=</span><span> torch.</span><span>rand</span><span>(</span><span>1</span><span><span>).</span><span>item</span><span>()</span></span></div></div><div><div><div>20</div></div><div><span>            </span><span>if</span><span><span> r </span><span>&lt;</span><span> p </span><span>/</span><span> q:</span></span></div></div><div><div><div>21</div></div><div><span><span>                </span></span><span>accepted_tokens.</span><span>append</span><span>(token_id)</span></div></div><div><div><div>22</div></div><div><span>            </span><span>else</span><span>:</span></div></div><div><div><div>23</div></div><div><span>                </span><span>break</span><span>  </span><span># 拒绝，停止后续验证</span></div></div><div><div><div>24</div></div><div><span>    </span><span>return</span><span> accepted_tokens</span></div></div></code></pre><div><div></div><div></div></div></figure><div></div></div><span>展开</span><span>收起</span></div></div></section><section><h3>2.6 加速来源<a href="#26-加速来源"><span>#</span></a></h3><ul>
<li>
<p>大模型从”K 次串行前向”变成”1 次并行前向”</p>
</li>
<li>
<p>草稿模型虽小，但猜对的部分都算白赚</p>
</li>
<li>
<p>瓶颈从”大模型调用次数”转移到”草稿命中率”</p>
</li>
</ul><hr /></section></section>
<section><h2>三、二者的联系：单步质量 → 吞吐加速<a href="#三二者的联系单步质量--吞吐加速"><span>#</span></a></h2>

<table><thead><tr><th></th><th>解码策略</th><th>投机解码</th></tr></thead><tbody><tr><td><strong>解决的问题</strong></td><td>选哪个 token（单步质量）</td><td>怎样更快生成更多 token（吞吐加速）</td></tr><tr><td><strong>关注层面</strong></td><td>单次采样的分布控制</td><td>跨 token 的调用次数优化</td></tr><tr><td><strong>改变分布吗</strong></td><td>会（温度/截断改变生成风格）</td><td>不会（最终分布严格等价大模型）</td></tr><tr><td><strong>依赖关系</strong></td><td>投机解码的草稿/目标模型内部都要用解码策略的采样</td><td>解码策略是投机解码的子组件</td></tr></tbody></table><p><strong>递进关系：</strong> 解码策略是投机解码的基础——投机解码里草稿模型和大模型各自的采样，用的就是 temperature/top-k/top-p 这套流水线。先学会”怎么选 token”，才能理解”怎么批量验证加速”。</p><section><h3>与前面内容的呼应<a href="#与前面内容的呼应"><span>#</span></a></h3><p>这四块从不同维度压缩自回归推理的延迟：</p>

<table><thead><tr><th>维度</th><th>对应内容</th><th>解决什么</th></tr></thead><tbody><tr><td>单次前向更省显存</td><td>FlashAttention</td><td>N×N 中间矩阵不落 HBM</td></tr><tr><td>历史状态更省显存</td><td>KV Cache</td><td>减少/管理要存的 K/V</td></tr><tr><td>选 token 更准</td><td>解码策略</td><td>logits → token 的分布控制</td></tr><tr><td>调大模型更少</td><td>投机解码</td><td>小模型先猜，大模型批量验证</td></tr></tbody></table><hr /></section></section>
<section><h2>四、速记<a href="#四速记"><span>#</span></a></h2><div><div><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>解码流水线：</span></div></div><div><div><div>2</div></div><div><span><span>  </span></span><span>logits → /T → Top-K → Top-p → Softmax → Multinomial</span></div></div><div><div><div>3</div></div><div><span><span>  </span></span><span>顺序铁律：先 Temperature 再截断，最后归一化采样</span></div></div><div><div><div>4</div></div><div>
</div></div><div><div><div>5</div></div><div><span>Top-p 实现六步：</span></div></div><div><div><div>6</div></div><div><span><span>  </span></span><span>sort降序 → softmax+cumsum → 找超阈值 → 右移一位 → 置-inf → scatter_恢复</span></div></div><div><div><div>7</div></div><div>
</div></div><div><div><div>8</div></div><div><span>投机解码接受概率：</span></div></div><div><div><div>9</div></div><div><span><span>  </span></span><span>α(x) = min(1, p(x)/q(x))</span></div></div><div><div><div>10</div></div><div><span><span>  </span></span><span>p ≥ q → 必接受</span></div></div><div><div><div>11</div></div><div><span><span>  </span></span><span>p &lt; q → 以 p/q 掷硬币，拒绝则 break</span></div></div><div><div><div>12</div></div><div>
</div></div><div><div><div>13</div></div><div><span>无损保证：</span></div></div><div><div><div>14</div></div><div><span><span>  </span></span><span>拒绝时停止草稿链 → 大模型重采样 → 最终分布 = 纯大模型自回归</span></div></div><div><div><div>15</div></div><div>
</div></div><div><div><div>16</div></div><div><span>四块加速维度：</span></div></div><div><div><div>17</div></div><div><span><span>  </span></span><span>FlashAttention → 单次前向显存</span></div></div><div><div><div>18</div></div><div><span><span>  </span></span><span>KV Cache       → 历史状态显存</span></div></div><div><div><div>19</div></div><div><span><span>  </span></span><span>解码策略        → 单步采样质量</span></div></div><div><div><div>20</div></div><div><span><span>  </span></span><span>投机解码        → 大模型调用次数</span></div></div></code></pre><div><div></div><div></div></div></figure><div></div></div><span>展开</span><span>收起</span></div></div></section>]]></content>
    </entry>
    <entry>
      <id>https://acoolfish.site/posts/gpu-memory-hierarchy/</id>
      <title type="text">GPU 架构与内存层级：SRAM、L2 与 FlashAttention 分块</title>
      <published>2026-11-15T00:00:00.000Z</published>
      <updated>2026-11-15T00:00:00.000Z</updated>
      <author><name>ACoolBlog</name></author>
      <link rel="alternate" href="https://acoolfish.site/posts/gpu-memory-hierarchy/"/>
      <summary type="text">从 SRAM、Shared Memory、L2 Cache 到 HBM 的层级关系，以及 FlashAttention 如何用分块把显存复杂度从 O(N²) 压到 O(N)。</summary>
      <content type="html"><![CDATA[<blockquote><p>整理自 <code>03_GPU_Architecture_and_Memory.ipynb</code> 的 Q1-Q4 知识点答疑。</p></blockquote>
<hr />
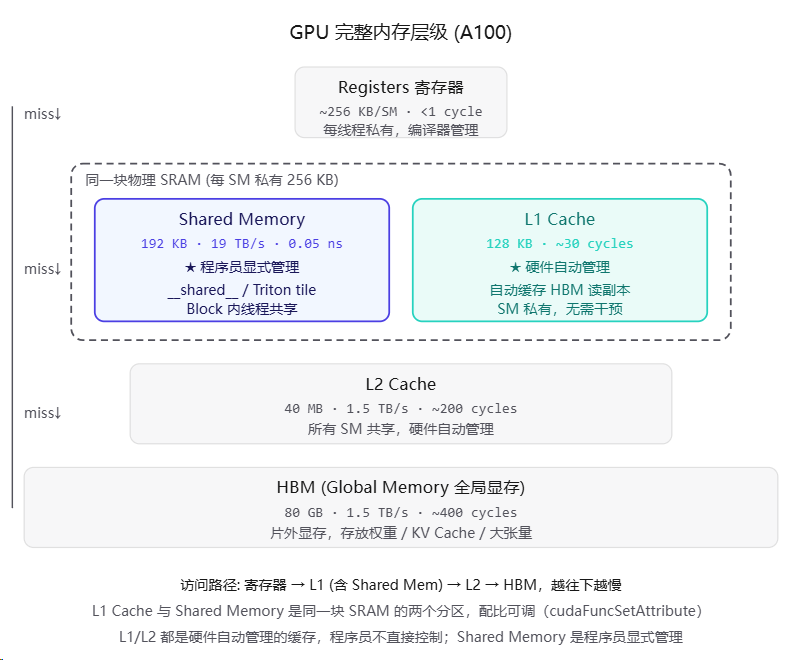
<section><h2>一、L2 Cache、SRAM、Shared Memory、HBM 的关系<a href="#一l2-cachesramshared-memoryhbm-的关系"><span>#</span></a></h2><p><strong>SRAM 不是新东西，就是你之前听到的 Shared Memory 的”物理材质”。</strong></p><p></p><figure><img src="/assets/posts/gpu-memory-hierarchy/gpu_memory_hierarchy.svg" alt="GPU 内存层级" /><figcaption>GPU 内存层级</figcaption></figure><p></p><ul>
<li><strong>SRAM (Static Random Access Memory)</strong> 是一种半导体存储工艺（静态随机存取存储器），速度快但密度低、贵。</li>
<li><strong>Shared Memory</strong> 是 CUDA 编程模型里的一个”逻辑抽象”——它是 SRAM 的一块切片，由同一个 Block 内的线程共享。所以文档里写”SRAM / 片上共享内存”是一回事。</li>
<li><strong>L2 Cache</strong> 也是片上缓存（也是 SRAM 工艺），但它是<strong>所有 SM 共享</strong>的，用作 HBM 读写的缓冲，由硬件自动管理，程序员一般不直接控制。</li>
<li><strong>HBM</strong> 是<strong>片外</strong>显存（高带宽 DRAM 堆叠在 GPU 封装旁边），容量大但慢，存放权重/KV Cache/大张量。</li>
</ul><section><h3>关键对比表<a href="#关键对比表"><span>#</span></a></h3>

<table><thead><tr><th>层级</th><th>容量 (A100)</th><th>带宽</th><th>谁管理</th><th>你写代码时怎么用</th></tr></thead><tbody><tr><td>Registers</td><td>~KB/线程</td><td>最快 (&lt;1 cycle)</td><td>编译器</td><td>局部变量，自动分配</td></tr><tr><td><strong>SRAM (= Shared Memory)</strong></td><td>192 KB/SM</td><td>19 TB/s</td><td><strong>程序员</strong></td><td><code>__shared__</code> 声明 / Triton 自动管理</td></tr><tr><td><strong>L2 Cache</strong></td><td>40 MB</td><td>1.5 TB/s</td><td><strong>硬件自动</strong></td><td>无法直接控制，但可命中</td></tr><tr><td><strong>HBM (Global)</strong></td><td>80 GB</td><td>1.5 TB/s</td><td>程序员</td><td><code>cudaMalloc</code> / PyTorch tensor</td></tr></tbody></table></section><section><h3>联系与区别<a href="#联系与区别"><span>#</span></a></h3><ul>
<li><strong>SRAM vs L2</strong>：都是片上 SRAM 工艺，但 SRAM 是每 SM 私有、程序员显式控制；L2 是全局共享、硬件自动管理。</li>
<li><strong>L2 vs HBM</strong>：L2 是 HBM 的”前置缓冲”——读写 HBM 时数据会先经过 L2，重复访问的数据可能命中 L2 而不用再去 HBM。L2 容量小（40 MB）所以命中率有限。</li>
<li><strong>Shared Memory vs HBM</strong>：完全不同层级的存储。Shared Memory 是 Block 内协作的”工作台”，HBM 是”大仓库”。</li>
</ul><hr /></section></section>
<section><h2>二、FlashAttention 如何用分块省显存<a href="#二flashattention-如何用分块省显存"><span>#</span></a></h2><p>你已懂 Online Softmax 原理，那分块的核心作用一句话：<strong>让 SRAM 容得下整个 tile，使 N×N 矩阵永远不写回 HBM。</strong></p><p></p><figure><img src="/assets/posts/gpu-memory-hierarchy/flash_attention_tiling.svg" alt="FlashAttention 分块" /><figcaption>FlashAttention 分块</figcaption></figure><p></p><section><h3>分块（Tiling）为什么能省显存——三步逻辑<a href="#分块tiling为什么能省显存三步逻辑"><span>#</span></a></h3><ol>
<li><strong>容量匹配</strong>：N×N 的完整 score 矩阵在 seq=128K 时高达 34 GB，根本塞不进 192 KB 的 SRAM。但切成 128×128 的块后只有 32 KB，SRAM 装得下。</li>
<li><strong>融合（Fusion）</strong>：一旦 tile 进了 SRAM，<code>S=QK^T → softmax → ×V</code> 这三步可以<strong>全部在 SRAM 内完成</strong>，不用中途写回 HBM。Online Softmax 在 SRAM 内维护每行的 <code>m</code>（max）和 <code>l</code>（sum of exp）两个标量，处理完所有 K_block 后再更新一次最终结果。</li>
<li><strong>N×N 永不落地 HBM</strong>：因为中间结果 S、P 都只在 SRAM 短暂存在，HBM 里只剩下 Q、K、V、O（输入输出），把<strong>显存复杂度从 O(N²) 压到 O(N)</strong>。</li>
</ol><p>注意：<strong>FlashAttention 没有减少 FLOPs</strong>（计算量还是 O(N²)），它减的是 <strong>HBM 读写量</strong>——而 GPU 大模型推理卡在 HBM 带宽上，这才是真正的瓶颈。</p><hr /></section></section>
<section><h2>三、分块之后的效果<a href="#三分块之后的效果"><span>#</span></a></h2><p>数字来自 notebook 的 Q3/Q4 验证。</p><section><h3>1. 显存复杂度：O(N²) → O(N)<a href="#1-显存复杂度on--on"><span>#</span></a></h3><ul>
<li>标准 Attention 必须在 HBM 里存下整个 N×N 的 <code>S=QK^T</code> 和 <code>P=softmax(S)</code>（每个 head 一份）。</li>
<li>FlashAttention 只在 SRAM 里临时存 tile，HBM 里只多存了 online softmax 的 <code>m, l</code> 两个标量/行 → 总量 <code>N × num_heads × 2 × 4 bytes</code>。</li>
<li>seq=128K 时：N² 项 34 GB → m,l 项 0.03 GB，整体从 38.65 GB 降到 4.33 GB（<strong>9x</strong>）。</li>
</ul></section><section><h3>2. HBM IO 次数：3+ 趟 N² → 1 趟分块<a href="#2-hbm-io-次数3-趟-n--1-趟分块"><span>#</span></a></h3><ul>
<li>Naive 的 HBM 往返：写 S → 读 S → 写 P → 读 P → 写 O，至少 3 次搬动 N×N。</li>
<li>FlashAttention 每个 tile 只 load 一次 Q/K/V block、write 一次 O block，N×N 矩阵根本不进 HBM。</li>
<li>在 seq=4K、block=128 时：完整 score 32 MB → 单 tile 32 KB，<strong>IO 减少 1024x</strong>。</li>
</ul></section><section><h3>3. 为什么 seq=512 时只省 1x？<a href="#3-为什么-seq512-时只省-1x"><span>#</span></a></h3><ul>
<li>短序列时 N² 项本来就小（512² × 2B = 0.5 MB），整个 attention 的显存被 Q/K/V/O 主导（这部分的复杂度是 O(N)，FA 也省不掉）。</li>
<li>随着 seq_len 增大，N² 项迅速膨胀主导总显存，FA 的”省 N²”优势才被放大。</li>
</ul></section><section><h3>数值效果汇总<a href="#数值效果汇总"><span>#</span></a></h3>

<table><thead><tr><th>指标</th><th>Naive</th><th>FlashAttention</th><th>倍数</th></tr></thead><tbody><tr><td>VRAM (seq=128K, 32 heads, dim=128)</td><td>38.65 GB</td><td>4.33 GB</td><td><strong>9x 节省</strong></td></tr><tr><td>HBM IO (seq=4K, block=128)</td><td>32 MB (N×N)</td><td>32 KB (单 tile)</td><td><strong>1024x 减少</strong></td></tr><tr><td>显存复杂度</td><td>O(N²)</td><td>O(N)</td><td>N² 项被干掉</td></tr><tr><td>计算量 FLOPs</td><td>O(N²)</td><td>O(N²)</td><td>不变</td></tr></tbody></table><hr /></section></section>
<section><h2>一句话总结<a href="#一句话总结"><span>#</span></a></h2><ul>
<li><strong>L2 Cache</strong> = 片上全局共享缓冲（硬件管理，40 MB），位于 HBM 和 SRAM 之间。</li>
<li><strong>SRAM = Shared Memory</strong> = 同一种 SRAM 工艺，但每 SM 私有、程序员显式管理（192 KB/SM，19 TB/s）。</li>
<li><strong>FlashAttention 分块</strong> = 把 N×N 矩阵切到能塞进 SRAM 的小块，让它在片上完成全部计算不写回 HBM，<strong>显存复杂度从 O(N²) 压到 O(N)，HBM IO 减少 1000x 量级</strong>。</li>
</ul></section>]]></content>
    </entry>
    <entry>
      <id>https://acoolfish.site/posts/kv-cache-and-flashattention/</id>
      <title type="text">浅解 KV Cache 与 FlashAttention</title>
      <published>2026-11-15T00:00:00.000Z</published>
      <updated>2026-11-15T00:00:00.000Z</updated>
      <author><name>ACoolBlog</name></author>
      <link rel="alternate" href="https://acoolfish.site/posts/kv-cache-and-flashattention/"/>
      <summary type="text">KV Cache 解决&quot;历史状态累积&quot;，FlashAttention 解决&quot;单次计算的瞬时访存&quot;——两堵显存墙的成因与解法。</summary>
      <content type="html"><![CDATA[<blockquote><p><strong>KV Cache 解决”历史状态累积”，FlashAttention 解决”单次计算的瞬时访存”</strong></p></blockquote>
<p>做大模型推理，绕不开两件事：</p>
<ul>
<li>上下文越来越长</li>
<li>显存越来越不够用</li>
</ul>
<p>但”显存不够”这件事，其实发生在两个不同的地方。一个是<strong>解码时历史状态越攒越多</strong>，一个是<strong>单次 Attention 计算时中间矩阵太大</strong>。</p>
<p>这两堵墙，对应两个关键技术：<strong>KV Cache</strong> 与 <strong>FlashAttention</strong>。</p>
<p>这篇文章把它们放在一起讲清楚——各自面临什么问题、怎么解决、彼此是什么关系。读完之后，你应该能一眼看出：“这个显存瓶颈，到底卡在哪一段”。</p>
<hr />
<section><h2>一、KV Cache：用显存换计算<a href="#一kv-cache用显存换计算"><span>#</span></a></h2><section><h3>它是什么<a href="#它是什么"><span>#</span></a></h3><p>自回归解码时，每生成一个新 token，模型都要让当前 token 的 Q 去和历史所有 token 的 K、V 做注意力。</p><p>如果不缓存，每步都要重算所有历史 token 的 K/V——代价随序列长度平方增长。</p><p><strong>KV Cache 的本质：把历史 token 的 Key 和 Value 预先算好并存下来，后续每步只算新 token 的 Q，直接复用缓存里的 K/V。</strong></p></section><section><h3>它面临的问题：显存随上下文线性增长<a href="#它面临的问题显存随上下文线性增长"><span>#</span></a></h3><p>缓存大小公式（标准 MHA）：</p><span><span><span>KV Cache Bytes≈2×L×B×Hkv×D×S\text{KV Cache Bytes} \approx 2 \times L \times B \times H_{kv} \times D \times S</span><span><span><span></span><span><span>KV Cache Bytes</span></span><span></span><span>≈</span><span></span></span><span><span></span><span>2</span><span></span><span>×</span><span></span></span><span><span></span><span>L</span><span></span><span>×</span><span></span></span><span><span></span><span>B</span><span></span><span>×</span><span></span></span><span><span></span><span><span>H</span><span><span><span><span><span><span></span><span><span><span>k</span><span>v</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>×</span><span></span></span><span><span></span><span>D</span><span></span><span>×</span><span></span></span><span><span></span><span>S</span></span></span></span></span><p>符号含义：</p><ul>
<li><code>2</code>：同时存 K 和 V</li>
<li><code>L</code>：层数（每层都要单独存一份）</li>
<li><code>B</code>：batch size（多请求各自复制）</li>
<li><code>H_kv</code>：KV 头数</li>
<li><code>D</code>：head dim</li>
<li><code>S</code>：上下文长度</li>
</ul><p><strong>注意：KV Cache 是”历史状态成本”。</strong> 上下文越长、batch 越大、层数越多，缓存就越大——而且这三个因素是<strong>相乘</strong>的。</p><p>看实际数字（L=32, H_kv=32, D=128）：</p>

<table><thead><tr><th>seq_len</th><th>KV Cache</th></tr></thead><tbody><tr><td>1024</td><td>≈ 0.54 GB</td></tr><tr><td>2048</td><td>≈ 1.07 GB</td></tr><tr><td>4096</td><td>≈ 2.15 GB</td></tr></tbody></table><p><strong>所以长上下文推理里，最先爆的往往不是算力，而是显存。</strong></p></section><section><h3>当前怎么解决：三个方向<a href="#当前怎么解决三个方向"><span>#</span></a></h3>

<table><thead><tr><th>方向</th><th>解决什么</th><th>直觉</th></tr></thead><tbody><tr><td><strong>MQA / GQA</strong></td><td>缩小 KV 头数</td><td>减少要存的 K/V 组数</td></tr><tr><td><strong>PagedAttention</strong></td><td>缓存分配与碎片</td><td>优化”怎么管 cache”</td></tr><tr><td><strong>MLA</strong></td><td>表示压缩</td><td>优化”cache 本身有多大”</td></tr></tbody></table><section><h4>方向一：MQA / GQA —— 压缩 KV 头数维度<a href="#方向一mqa--gqa--压缩-kv-头数维度"><span>#</span></a></h4><p>真正决定显存大小的，不是 query heads 有多少，而是<strong>要存多少组 K/V</strong>。</p><ul>
<li><strong>MHA</strong>：每个 query head 都有自己对应的 K/V，缓存压力最大</li>
<li><strong>MQA</strong>：多个 query head 共享同一组 K/V，缓存立刻变小</li>
<li><strong>GQA</strong>：介于两者之间，把 query heads 分组共享 K/V</li>
</ul><p>看数字（S=4096, L=32, D=128）：</p>

<table><thead><tr><th>方案</th><th>KV 头数</th><th>KV Cache</th></tr></thead><tbody><tr><td>MHA</td><td>32</td><td>≈ 2.15 GB</td></tr><tr><td>GQA</td><td>8</td><td>≈ 0.54 GB</td></tr><tr><td>MQA</td><td>1</td><td>≈ 0.07 GB</td></tr></tbody></table><p>只要 KV 头数下降，缓存就按比例下降。</p></section><section><h4>方向二：PagedAttention —— 缓存管理（系统层）<a href="#方向二pagedattention--缓存管理系统层"><span>#</span></a></h4><p>把 KV cache 按页组织，避免长序列和多请求场景里出现连续大块显存分配困难。</p><ul>
<li>重点不是把 K/V 表示本身压缩掉</li>
<li>而是让缓存的<strong>存储、搬运和复用</strong>更稳定</li>
<li>解决的是碎片化和分配问题</li>
</ul></section><section><h4>方向三：MLA —— 表示压缩（结构层）<a href="#方向三mla--表示压缩结构层"><span>#</span></a></h4><p>把原本需要长期保存的 KV 表示压到更低维的潜变量空间里。</p><ul>
<li>直接降低每个 token 需要保留的缓存体积</li>
<li>解决的是”cache 本身有多大”</li>
</ul><blockquote><p><strong>区别：PagedAttention 是在优化”怎么管 cache”，MLA 是在优化”cache 本身有多大”。前者偏系统实现，后者偏表示结构。</strong></p></blockquote></section></section><section><h3>三个常见误区<a href="#三个常见误区"><span>#</span></a></h3><ul>
<li>KV cache 不只和 token 数有关，它还和层数、batch size、KV 头数一起增长</li>
<li>MQA / GQA 不是单纯改名字，而是在实打实地压低缓存体积</li>
<li>PagedAttention 解决的是缓存管理和碎片化，<strong>不等于</strong>表示压缩</li>
<li>MLA 解决的是表示体积，<strong>不等于</strong>把调度和分配问题也一并解决</li>
</ul><hr /></section></section>
<section><h2>二、FlashAttention：把访存压下去<a href="#二flashattention把访存压下去"><span>#</span></a></h2><section><h3>为什么需要FlashAttention：标准 Attention 的显存瓶颈<a href="#为什么需要flashattention标准-attention-的显存瓶颈"><span>#</span></a></h3><p>标准 Attention 的问题不是”算不动”，而是<strong>中间结果太大</strong>。</p><p>一次 <code>QK^T</code> 会生成接近 N×N 的注意力矩阵。如果这个矩阵要频繁写回 HBM（显存），再读出来做 Softmax 和后续乘法，显存访问次数就会非常多。</p><p>这意味着两件事：</p><ol>
<li><strong>中间结果占用的显存会迅速膨胀</strong>——空间复杂度 O(N²)</li>
<li><strong>数据搬运会比计算本身更容易成为瓶颈</strong>——HBM 读写是性能墙</li>
</ol><blockquote><p><strong>标准 Softmax 的痛点：</strong> 求每一行的最大值 m、求指数和 l、再算最终结果——在算出所有 x 之前，你无法算出 m 和 l，因此<strong>必须把所有的 x 先存下来</strong>。在 Attention 中，x 就是那个大规模的 S = QK^T 矩阵。</p></blockquote></section><section><h3>什么是 FlashAttention：tiling + online softmax<a href="#什么是-flashattentiontiling--online-softmax"><span>#</span></a></h3><p>核心思路：<strong>不要把完整 score 矩阵落到显存里，而是把 Q/K/V 分块，在小块上边算边更新 softmax 统计量和输出。</strong></p><section><h4>机制一：Tiling（分块）<a href="#机制一tiling分块"><span>#</span></a></h4><p>把 Q、K、V 切成能放进片上 SRAM 的小块。通过外层循环遍历 Q 块，内层循环遍历 K/V 块，在保持数学上完全等价的前提下，将显存消耗从 O(N²) 降到 O(N)。</p><p>看分块的效果（seq_len=4096）：</p>

<table><thead><tr><th>tile_size</th><th>tile 工作集</th><th>IO 压力降低</th></tr></thead><tbody><tr><td>64</td><td>≈ 8 KB</td><td>≈ 4096x</td></tr><tr><td>128</td><td>≈ 32 KB</td><td>≈ 1024x</td></tr><tr><td>256</td><td>≈ 128 KB</td><td>≈ 256x</td></tr></tbody></table><p>tile 越小，工作集越小，但需要调度的 tile 数越多。</p></section><section><h4>机制二：Online Softmax（在线归约）<a href="#机制二online-softmax在线归约"><span>#</span></a></h4><p>在处理每个块时，就把局部最大值 m 和指数和 l 更新掉，避免把完整注意力矩阵写回 HBM。</p><p><strong>更新公式：</strong></p><ul>
<li>新的局部最大值：<span><span>mnew=max⁡(mold,mblock)m_{new} = \max(m_{old}, m_{block})</span><span><span><span></span><span><span>m</span><span><span><span><span><span><span></span><span><span><span>n</span><span>e</span><span>w</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>=</span><span></span></span><span><span></span><span>max</span><span>(</span><span><span>m</span><span><span><span><span><span><span></span><span><span><span>o</span><span>l</span><span>d</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>,</span><span></span><span><span>m</span><span><span><span><span><span><span></span><span><span><span>b</span><span>l</span><span>oc</span><span>k</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span></li>
<li>修正旧的指数和：<span><span>lnew=lold⋅emold−mnew+lblock⋅emblock−mnewl_{new} = l_{old} \cdot e^{m_{old} - m_{new}} + l_{block} \cdot e^{m_{block} - m_{new}}</span><span><span><span></span><span><span>l</span><span><span><span><span><span><span></span><span><span><span>n</span><span>e</span><span>w</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>=</span><span></span></span><span><span></span><span><span>l</span><span><span><span><span><span><span></span><span><span><span>o</span><span>l</span><span>d</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>⋅</span><span></span></span><span><span></span><span><span>e</span><span><span><span><span><span><span></span><span><span><span><span>m</span><span><span><span><span><span><span></span><span><span><span>o</span><span>l</span><span>d</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>−</span><span><span>m</span><span><span><span><span><span><span></span><span><span><span>n</span><span>e</span><span>w</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></span></span></span></span></span><span></span><span>+</span><span></span></span><span><span></span><span><span>l</span><span><span><span><span><span><span></span><span><span><span>b</span><span>l</span><span>oc</span><span>k</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>⋅</span><span></span></span><span><span></span><span><span>e</span><span><span><span><span><span><span></span><span><span><span><span>m</span><span><span><span><span><span><span></span><span><span><span>b</span><span>l</span><span>oc</span><span>k</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>−</span><span><span>m</span><span><span><span><span><span><span></span><span><span><span>n</span><span>e</span><span>w</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></li>
<li>修正旧的输出结果：<span><span>Onew=Oold⋅lold⋅emold−mnewlnew+eSblock−mnew⋅VblocklnewO_{new} = O_{old} \cdot \frac{l_{old} \cdot e^{m_{old} - m_{new}}}{l_{new}} + \frac{e^{S_{block} - m_{new}} \cdot V_{block}}{l_{new}}</span><span><span><span></span><span><span>O</span><span><span><span><span><span><span></span><span><span><span>n</span><span>e</span><span>w</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>=</span><span></span></span><span><span></span><span><span>O</span><span><span><span><span><span><span></span><span><span><span>o</span><span>l</span><span>d</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>⋅</span><span></span></span><span><span></span><span><span></span><span><span><span><span><span><span></span><span><span><span><span>l</span><span><span><span><span><span><span></span><span><span><span>n</span><span>e</span><span>w</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span><span><span></span><span></span></span><span><span></span><span><span><span><span>l</span><span><span><span><span><span><span></span><span><span><span>o</span><span>l</span><span>d</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>⋅</span><span><span>e</span><span><span><span><span><span><span></span><span><span><span><span>m</span><span><span><span><span><span><span></span><span><span>o</span><span>l</span><span>d</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>−</span><span><span>m</span><span><span><span><span><span><span></span><span><span>n</span><span>e</span><span>w</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span></span><span></span><span>+</span><span></span></span><span><span></span><span><span></span><span><span><span><span><span><span></span><span><span><span><span>l</span><span><span><span><span><span><span></span><span><span><span>n</span><span>e</span><span>w</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span><span><span></span><span></span></span><span><span></span><span><span><span><span>e</span><span><span><span><span><span><span></span><span><span><span><span>S</span><span><span><span><span><span><span></span><span><span>b</span><span>l</span><span>oc</span><span>k</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>−</span><span><span>m</span><span><span><span><span><span><span></span><span><span>n</span><span>e</span><span>w</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></span></span></span></span></span><span>⋅</span><span><span>V</span><span><span><span><span><span><span></span><span><span><span>b</span><span>l</span><span>oc</span><span>k</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span></span></span></span></span></li>
</ul><p><strong>关键：换底修正。</strong> 当新块的最大值更大时，用指数因子 <span><span>emold−mnewe^{m_{old}-m_{new}}</span><span><span><span></span><span><span>e</span><span><span><span><span><span><span></span><span><span><span><span>m</span><span><span><span><span><span><span></span><span><span><span>o</span><span>l</span><span>d</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>−</span><span><span>m</span><span><span><span><span><span><span></span><span><span><span>n</span><span>e</span><span>w</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></span></span>（≤1）把旧结果”打折”到新基准下，不需要重新算前面的块。</p></section><section><h4>本质：把压力从 HBM 挪到 SRAM<a href="#本质把压力从-hbm-挪到-sram"><span>#</span></a></h4><ul>
<li><strong>HBM</strong>：容量大，但访问代价高</li>
<li><strong>SRAM</strong>：容量小，但离计算更近、访问更快</li>
</ul><p>FlashAttention 让中间数据停留在 SRAM 里，把 HBM 主要留给必要的输入输出。计算量没有本质减少，但大规模中间矩阵反复读写 HBM 的情况被明显压缩了。</p><blockquote><p><strong>这就是为什么 FlashAttention 常被描述为”IO-aware”：它不是单纯追求更多算术，而是通过更好的存储层级利用，减少最贵的数据搬运。</strong></p></blockquote></section></section><section><h3>工业界演进：V1 → V2 → V3 → V4<a href="#工业界演进v1--v2--v3--v4"><span>#</span></a></h3>

<table><thead><tr><th>版本</th><th>年份</th><th>核心创新</th></tr></thead><tbody><tr><td><strong>FA-1</strong></td><td>2022</td><td>Tiling + Recomputation，空间复杂度 O(N²)→O(N)。局限：Non-Matmul 计算偏多，Occupancy 不高</td></tr><tr><td><strong>FA-2</strong></td><td>2023</td><td>减少 Non-Matmul FLOPs（延迟归一化）；Sequence Parallelism（序列级并行）</td></tr><tr><td><strong>FA-3</strong></td><td>2024</td><td>绑定 Hopper (H100)：WGMMA 异步计算、TMA 硬件搬运器、2-Stage→Ping-Pong Pipeline</td></tr><tr><td><strong>FA-4</strong></td><td>—</td><td>CuTeDSL 与 Blackwell 方向，代码生成 + kernel 组织一体化</td></tr></tbody></table><blockquote><p><strong>FA-2 优化的关键思路：</strong> V1 每步都做标量缩放（跑在慢的 CUDA Core 上）。如果把 <code>v_block</code> 的缩放统一推迟到整行结束只做一次，能减少 non-matmul FLOPs，把更多算力留给 Tensor Core 的矩阵乘。</p></blockquote></section><section><h3>四个常见误区<a href="#四个常见误区"><span>#</span></a></h3><ul>
<li>FlashAttention <strong>不是</strong>把计算量消掉了，而是减少了中间结果落到 HBM 的次数</li>
<li><code>tiling</code> 不是为了形式更复杂，而是为了让中间状态能留在更合适的存储层</li>
<li><code>online softmax</code> 不是额外技巧，而是把归约过程前移到块内处理</li>
<li>如果只盯着 FLOPs，不看数据搬运，通常会误判 FlashAttention 的收益</li>
</ul><hr /></section></section>
<section><h2>三、两张表放一起：它们到底在解决什么<a href="#三两张表放一起它们到底在解决什么"><span>#</span></a></h2>

<table><thead><tr><th></th><th>KV Cache</th><th>FlashAttention</th></tr></thead><tbody><tr><td><strong>显存问题在哪</strong></td><td>解码阶段，每步累积的 K/V</td><td>单次计算，N×N 中间矩阵</td></tr><tr><td><strong>随什么增长</strong></td><td>序列长度 S（线性，O(L·S)）</td><td>序列长度 N（平方，O(N²)）</td></tr><tr><td><strong>关注维度</strong></td><td>时间累积（跨 token、跨时间步）</td><td>空间瞬时（一次计算内）</td></tr><tr><td><strong>解决方向</strong></td><td>GQA/MQA/MLA、PagedAttention</td><td>tiling + online softmax</td></tr><tr><td><strong>谁在省显存</strong></td><td>减少要存的状态 / 管好已存状态</td><td>不让中间矩阵落 HBM</td></tr></tbody></table></section>
<section><h2>四、重点小结<a href="#四重点小结"><span>#</span></a></h2><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>KV Cache 增长：  2 × L × B × H_kv × D × S  （线性于 S）</span></div></div><div><div><div>2</div></div><div><span>标准 Attention 中间矩阵：  N × N  （平方于 N）</span></div></div><div><div><div>3</div></div><div><span>FlashAttention 后：       O(N)   （分块 + 在线归约）</span></div></div><div><div><div>4</div></div><div>
</div></div><div><div><div>5</div></div><div><span>online softmax 换底修正三件套：</span></div></div><div><div><div>6</div></div><div><span><span>  </span></span><span>m_new = max(m_old, m_block)</span></div></div><div><div><div>7</div></div><div><span><span>  </span></span><span>l_new = l_old · e^(m_old−m_new) + Σ P_ij</span></div></div><div><div><div>8</div></div><div><span><span>  </span></span><span>O_new = O_old · (l_old·e^(m_old−m_new)/l_new) + (P_ij@V)/l_new</span></div></div><div><div><div>9</div></div><div>
</div></div><div><div><div>10</div></div><div><span>KV Cache 三个减负方向：</span></div></div><div><div><div>11</div></div><div><span><span>  </span></span><span>MQA/GQA   → 压缩 KV 头数</span></div></div><div><div><div>12</div></div><div><span><span>  </span></span><span>PagedAttn → 缓存管理（系统层）</span></div></div><div><div><div>13</div></div><div><span><span>  </span></span><span>MLA       → 表示压缩（结构层）</span></div></div></code></pre><div><div></div><div></div></div></figure></div></section>]]></content>
    </entry>
    <entry>
      <id>https://acoolfish.site/posts/rl-series-00/</id>
      <title type="text">一个方程的四种解法：PPO / DPO / GRPO / GSPO</title>
      <published>2026-11-15T00:00:00.000Z</published>
      <updated>2026-11-15T00:00:00.000Z</updated>
      <author><name>ACoolBlog</name></author>
      <link rel="alternate" href="https://acoolfish.site/posts/rl-series-00/"/>
      <summary type="text">RLHF 的目标方程只有一行，PPO / DPO / GRPO / GSPO 是它的四种解法。从策略梯度、优势函数到重要性采样，一篇打通四个算法的共同骨架。</summary>
      <content type="html"><![CDATA[<blockquote><p>本系列开篇。系列目录：《一个方程的四种解法》——篇 0 总览 / 篇 1 PPO / 篇 2 DPO / 篇 3 GRPO / 篇 4 GSPO。</p></blockquote>
<section><h2>1. 从 InstructGPT 说起：RLHF 要优化的方程<a href="#1-从-instructgpt-说起rlhf-要优化的方程"><span>#</span></a></h2><section><h3>1.1 InstructGPT 三阶段<a href="#11-instructgpt-三阶段"><span>#</span></a></h3><p>预训练模型学会了”接话”，但没学会”好好回答”。原因很根本：预训练目标是预测下一个词，而”有用、诚实、无害”从来不是下一个词——<strong>目标错位</strong>。</p><p>InstructGPT（2022）给出的流水线分三步：</p><ol>
<li><strong>SFT（监督微调）</strong>：拿人工写的高质量示范回答做下一词预测，让模型学会”回答长什么样”</li>
<li><strong>RM（奖励模型）</strong>：拿同一个问题的多个回答让人类排偏好，训一个模型学会打分</li>
<li><strong>RL（强化学习）</strong>：用打分去优化生成模型</li>
</ol><p>为什么 SFT 不够？示范数据又贵又有限，而且只能模仿——<strong>教不出超过示范水平的行为</strong>。</p><p>那有了 RM 为什么还要 RL？因为 RM 只会<strong>打分</strong>，不会<strong>生成</strong>。想找”得分最高的回答”，就得把所有可能的回答都拿出来比一遍。但可能的回答有多少？词表十几万，回答动辄几百上千个词，组合出来的候选数量是天文数字，根本没法一个个试。RL 的做法是：让模型自己生成回答，看分数，按分数调参数，一步步往高分方向走。</p></section><section><h3>1.2 目标方程：多拿分，但别走太远<a href="#12-目标方程多拿分但别走太远"><span>#</span></a></h3><p>第三步要优化的目标，就是下面这个方程：</p><span><span><span>max⁡πθ    Ex∼D,  y∼πθ(⋅∣x)[ r(x,y) ]  −  β⋅DKL(πθ ∥ πref)(0.1)\max_{\pi_\theta}\;\; \mathbb{E}_{x \sim \mathcal{D},\; y \sim \pi_\theta(\cdot|x)}\big[\, r(x,y) \,\big] \;-\; \beta \cdot D_{\mathrm{KL}}\big( \pi_\theta \,\|\, \pi_{\mathrm{ref}} \big)
\tag{0.1}</span><span><span><span></span><span><span><span><span><span><span></span><span><span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span><span><span></span><span><span>max</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span></span><span></span><span><span>E</span><span><span><span><span><span><span></span><span><span><span>x</span><span>∼</span><span>D</span><span>,</span><span></span><span>y</span><span>∼</span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>⋅</span><span>∣</span><span>x</span><span>)</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>[</span></span><span></span><span>r</span><span>(</span><span>x</span><span>,</span><span></span><span>y</span><span>)</span><span></span><span><span>]</span></span><span></span><span></span><span>−</span><span></span><span></span></span><span><span></span><span>β</span><span></span><span>⋅</span><span></span></span><span><span></span><span><span>D</span><span><span><span><span><span><span></span><span><span><span><span>KL</span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>(</span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>∥</span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span><span><span>ref</span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>)</span></span></span><span><span></span><span><span>(</span><span><span>0.1</span></span><span>)</span></span></span></span></span></span><p>逐项拆开：</p><ul>
<li><span><span>Ey∼πθ[r(x,y)]\mathbb{E}_{y \sim \pi_\theta}[r(x,y)]</span><span><span><span></span><span><span>E</span><span><span><span><span><span><span></span><span><span><span>y</span><span>∼</span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>[</span><span>r</span><span>(</span><span>x</span><span>,</span><span></span><span>y</span><span>)]</span></span></span></span>：模型自己生成的回答，在打分器那里的<strong>平均得分</strong>——期望就是按概率加权的平均</li>
<li><span><span>DKL(πθ∥πref)D_{\mathrm{KL}}(\pi_\theta \| \pi_{\mathrm{ref}})</span><span><span><span></span><span><span>D</span><span><span><span><span><span><span></span><span><span><span><span>KL</span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∥</span><span><span>π</span><span><span><span><span><span><span></span><span><span><span><span>ref</span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span> 是 KL 散度（Kullback–Leibler divergence，衡量两个概率分布差多远的一个量）：这里衡量当前模型和<strong>参考模型</strong>（SFT 模型，训练全程冻结不动）的偏离程度——改了多少</li>
<li><span><span>β\beta</span><span><span><span></span><span>β</span></span></span></span>：约束强度。<span><span>β\beta</span><span><span><span></span><span>β</span></span></span></span> 越大，“偏得太远”被罚得越狠；<span><span>β\beta</span><span><span><span></span><span>β</span></span></span></span> 大到极限，模型完全不敢动（等于没做 RL）；<span><span>β\beta</span><span><span><span></span><span>β</span></span></span></span> 小到 0，只顾刷分不管别的（模型会崩）</li>
</ul></section><section><h3>1.3 为什么必须有 KL 项<a href="#13-为什么必须有-kl-项"><span>#</span></a></h3><p>如果只最大化奖励会发生什么？——<strong>Reward Hacking</strong>（奖励作弊）。</p><p>RM 是从有限偏好数据里学出来的<strong>有缺陷的智能体</strong>。古德哈特定律说：当一个指标变成目标，它就不再是好指标。无约束地最大化一个有缺陷的代理，等于无限放大它的盲点——历史上真实发生过的行为：输出越来越长（长回答更容易被偏好）、堆砌讨好句式、重复”高分组句型”直到胡言乱语。</p><p>KL 项同时干三件事：<strong>限制作弊空间</strong>（RM 不可靠的区域通常离参考模型很远）、<strong>保住语言能力</strong>（语言能力存在参考模型的参数里，跑太远等于失忆）、<strong>保住多样性</strong>（无约束优化会让输出坍缩到少数几个高分模板上）。</p><blockquote><p>后面要讲的四个算法，优化的都是这个方程，区别只在解法：<strong>PPO</strong>（Proximal Policy Optimization，近端策略优化）用在线强化学习老老实实解它；<strong>DPO</strong>（Direct Preference Optimization，直接偏好优化）把它的最优解直接推导成一个损失函数；<strong>GRPO</strong>（Group Relative Policy Optimization，组相对策略优化）和 <strong>GSPO</strong>（Group Sequence Policy Optimization，组序列策略优化）换掉它里面”优势”的估计方式。把方程记牢，后面每个算法都能对号入座。</p></blockquote><hr /></section></section>
<section><h2>2. 术语对照：强化学习的词放到 LLM 里是什么<a href="#2-术语对照强化学习的词放到-llm-里是什么"><span>#</span></a></h2><p>强化学习文献里的一套词汇，放到 LLM 场景里都有明确对应：</p>

<table><thead><tr><th>RL 概念</th><th>LLM 中的对应物</th><th>说明</th></tr></thead><tbody><tr><td>智能体 agent</td><td>被训练的 LLM，即策略 <span><span>πθ\pi_\theta</span><span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></td><td>一般由 SFT 模型初始化</td></tr><tr><td>环境 environment</td><td>prompt + 生成过程</td><td></td></tr><tr><td>状态 <span><span>sts_t</span><span><span><span></span><span><span>s</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></td><td>已生成的 token 前缀 <span><span>(x, y&lt;t)(x,\, y_{&lt;t})</span><span><span><span></span><span>(</span><span>x</span><span>,</span><span></span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span></td><td>生成第 <span><span>tt</span><span><span><span></span><span>t</span></span></span></span> 个 token 前的全部信息</td></tr><tr><td>动作 <span><span>ata_t</span><span><span><span></span><span><span>a</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></td><td>下一个 token <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></td><td>从词表里选一个词</td></tr><tr><td>轨迹 <span><span>τ\tau</span><span><span><span></span><span>τ</span></span></span></span></td><td>一次完整回复 <span><span>(x,y)(x, y)</span><span><span><span></span><span>(</span><span>x</span><span>,</span><span></span><span>y</span><span>)</span></span></span></span></td><td></td></tr><tr><td>奖励 <span><span>rr</span><span><span><span></span><span>r</span></span></span></span></td><td>对完整回复的标量分</td><td>RM 打分 / 规则判分 / 偏好隐式</td></tr></tbody></table><p>表格之后补两个容易卡住的点。</p><p><strong>“马尔可夫”是什么意思。</strong> 上表说 LLM 生成是个”马尔可夫决策过程”，马尔可夫的意思只有一句话：<strong>决定下一步只需要当前状态，不需要更早的历史</strong>。对 LLM 来说，生成下一个词只看已有的前缀——而前缀本身就包含了全部历史——所以天然满足，不用额外做什么。</p><p><strong>一条回复的生成概率，是逐词连乘的。</strong> 模型每一步做的事情是：看到前缀，给词表里<strong>每一个</strong>词算一个概率，然后按概率挑一个。第 <span><span>tt</span><span><span><span></span><span>t</span></span></span></span> 步选中词 <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 的概率，记作 <span><span>πθ(yt∣x,y&lt;t)\pi_\theta(y_t \mid x, y_{&lt;t})</span><span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>∣</span><span></span></span><span><span></span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span>，其中 <span><span>y&lt;ty_{&lt;t}</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 表示”第 <span><span>tt</span><span><span><span></span><span>t</span></span></span></span> 步之前已经生成的所有词”。那么整条回复 <span><span>yy</span><span><span><span></span><span>y</span></span></span></span> 被生成出来的概率，就是把每一步的概率乘起来：</p><span><span><span>πθ(y∣x)  =  ∏t=1∣y∣πθ(yt ∣ x, y&lt;t)(0.2)\pi_\theta(y|x) \;=\; \prod_{t=1}^{|y|} \pi_\theta\big(y_t \,\big|\, x,\, y_{&lt;t}\big)
\tag{0.2}</span><span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>y</span><span>∣</span><span>x</span><span>)</span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span><span><span><span><span><span></span><span><span><span>t</span><span>=</span><span>1</span></span></span></span><span><span></span><span><span>∏</span></span></span><span><span></span><span><span><span>∣</span><span>y</span><span>∣</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>(</span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span><span><span><span><span><span><span></span><span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>x</span><span>,</span><span></span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>)</span></span></span><span><span></span><span><span>(</span><span><span>0.2</span></span><span>)</span></span></span></span></span></span><p>举个数：一句 3 个词的回答，三步分别以 0.2、0.5、0.1 的概率选中了对应的词，整句的生成概率就是 <span><span>0.2×0.5×0.1=0.010.2 \times 0.5 \times 0.1 = 0.01</span><span><span><span></span><span>0.2</span><span></span><span>×</span><span></span></span><span><span></span><span>0.5</span><span></span><span>×</span><span></span></span><span><span></span><span>0.1</span><span></span><span>=</span><span></span></span><span><span></span><span>0.01</span></span></span></span>。</p><p>这个连乘结构后面会反复用到——讲 GSPO 时它的”序列级比率”，本质上就是对这里每个词的折算系数取对数再平均。</p><hr /></section>
<section><h2>3. 推导①：策略梯度——往哪个方向走<a href="#3-推导策略梯度往哪个方向走"><span>#</span></a></h2><section><h3>3.1 先把符号说清楚<a href="#31-先把符号说清楚"><span>#</span></a></h3><ul>
<li>目标：<span><span>J(θ)=Eτ∼πθ[R(τ)]J(\theta) = \mathbb{E}_{\tau \sim \pi_\theta}[R(\tau)]</span><span><span><span></span><span>J</span><span>(</span><span>θ</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span><span>E</span><span><span><span><span><span><span></span><span><span><span>τ</span><span>∼</span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>[</span><span>R</span><span>(</span><span>τ</span><span>)]</span></span></span></span>。<span><span>τ=(x,y)\tau = (x, y)</span><span><span><span></span><span>τ</span><span></span><span>=</span><span></span></span><span><span></span><span>(</span><span>x</span><span>,</span><span></span><span>y</span><span>)</span></span></span></span> 是一条完整回复，<span><span>R(τ)R(\tau)</span><span><span><span></span><span>R</span><span>(</span><span>τ</span><span>)</span></span></span></span> 是它的<strong>总分</strong>。LLM 里通常整条回复只打一个分，所以 <span><span>R(τ)R(\tau)</span><span><span><span></span><span>R</span><span>(</span><span>τ</span><span>)</span></span></span></span> 就是 <span><span>r(x,y)r(x,y)</span><span><span><span></span><span>r</span><span>(</span><span>x</span><span>,</span><span></span><span>y</span><span>)</span></span></span></span></li>
<li><span><span>θ\theta</span><span><span><span></span><span>θ</span></span></span></span> 是模型参数；<span><span>∇θ\nabla_\theta</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 表示”对参数求梯度”。训练就是靠这个梯度做梯度上升</li>
<li>一个重要前提：<strong>打分器是冻结的</strong>（RM 训好就不再动），所以 <span><span>R(τ)R(\tau)</span><span><span><span></span><span>R</span><span>(</span><span>τ</span><span>)</span></span></span></span> 里不含 <span><span>θ\theta</span><span><span><span></span><span>θ</span></span></span></span>，对 <span><span>θ\theta</span><span><span><span></span><span>θ</span></span></span></span> 求导时是常数</li>
</ul></section><section><h3>3.2 三步推导<a href="#32-三步推导"><span>#</span></a></h3><p><strong>第一步：把期望拆成求和。</strong> 期望就是按概率加权的平均，对所有可能的回复 <span><span>τ\tau</span><span><span><span></span><span>τ</span></span></span></span> 加总：</p><span><span><span>J(θ)=∑τπθ(τ) R(τ)J(\theta) = \sum_\tau \pi_\theta(\tau)\, R(\tau)</span><span><span><span></span><span>J</span><span>(</span><span>θ</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span><span><span><span><span><span></span><span><span>τ</span></span></span><span><span></span><span><span>∑</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>τ</span><span>)</span><span></span><span>R</span><span>(</span><span>τ</span><span>)</span></span></span></span></span><p>两边对 <span><span>θ\theta</span><span><span><span></span><span>θ</span></span></span></span> 求导。<span><span>R(τ)R(\tau)</span><span><span><span></span><span>R</span><span>(</span><span>τ</span><span>)</span></span></span></span> 是常数（刚说过），有限项求和与求导可以交换顺序，所以导数只落在概率 <span><span>πθ(τ)\pi_\theta(\tau)</span><span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>τ</span><span>)</span></span></span></span> 上：</p><span><span><span>∇θJ(θ)=∑τ∇θπθ(τ) R(τ)(0.3)\nabla_\theta J(\theta) = \sum_\tau \nabla_\theta \pi_\theta(\tau)\, R(\tau)
\tag{0.3}</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>J</span><span>(</span><span>θ</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span><span><span><span><span><span></span><span><span>τ</span></span></span><span><span></span><span><span>∑</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>τ</span><span>)</span><span></span><span>R</span><span>(</span><span>τ</span><span>)</span></span><span><span></span><span><span>(</span><span><span>0.3</span></span><span>)</span></span></span></span></span></span><p><strong>第二步：log 技巧——变成”采样能估”的形式。</strong> (0.3) 有个现实问题：它要求遍历所有可能的回复，而回复数量是天文数字，列举不出来，只能采样。要让”采样平均”成为可能，先做一个恒等变形。由链式法则，<span><span>∇θlog⁡πθ=∇θπθ / πθ\nabla_\theta \log \pi_\theta = \nabla_\theta \pi_\theta \,/\, \pi_\theta</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>=</span><span></span></span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>/</span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span>，移项得：</p><span><span><span>∇θπθ(τ)=πθ(τ)⋅∇θlog⁡πθ(τ)\nabla_\theta \pi_\theta(\tau) = \pi_\theta(\tau) \cdot \nabla_\theta \log \pi_\theta(\tau)</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>τ</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>τ</span><span>)</span><span></span><span>⋅</span><span></span></span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>τ</span><span>)</span></span></span></span></span><p>代回 (0.3)，再注意到"<span><span>∑π×(⋅)\sum \pi \times (\cdot)</span><span><span><span></span><span>∑</span><span></span><span>π</span><span></span><span>×</span><span></span></span><span><span></span><span>(</span><span>⋅</span><span>)</span></span></span></span>"正是期望的定义，又变回期望形式：</p><span><span><span>∇θJ(θ)=Eτ∼πθ[ ∇θlog⁡πθ(τ)⋅R(τ) ](0.4)\nabla_\theta J(\theta) = \mathbb{E}_{\tau \sim \pi_\theta}\Big[\, \nabla_\theta \log \pi_\theta(\tau) \cdot R(\tau) \,\Big]
\tag{0.4}</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>J</span><span>(</span><span>θ</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span><span>E</span><span><span><span><span><span><span></span><span><span><span>τ</span><span>∼</span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>[</span></span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>τ</span><span>)</span><span></span><span>⋅</span><span></span></span><span><span></span><span>R</span><span>(</span><span>τ</span><span>)</span><span></span><span><span>]</span></span></span><span><span></span><span><span>(</span><span><span>0.4</span></span><span>)</span></span></span></span></span></span><p>现在是”某个量的期望”，而期望可以用采样平均估计：采 <span><span>NN</span><span><span><span></span><span>N</span></span></span></span> 条回复，每条算一次 <span><span>∇θlog⁡πθ(τ)⋅R(τ)\nabla_\theta \log \pi_\theta(\tau) \cdot R(\tau)</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>τ</span><span>)</span><span></span><span>⋅</span><span></span></span><span><span></span><span>R</span><span>(</span><span>τ</span><span>)</span></span></span></span>，取平均。这就是能落地计算的形式。</p><p><strong>第三步：把轨迹概率拆开。</strong> 一条回复的生成概率（式 0.2）是逐词连乘，再乘上 prompt 出现的概率 <span><span>p(x)p(x)</span><span><span><span></span><span>p</span><span>(</span><span>x</span><span>)</span></span></span></span>：<span><span>πθ(τ)=p(x)⋅∏tπθ(yt∣x,y&lt;t)\pi_\theta(\tau) = p(x) \cdot \prod_t \pi_\theta(y_t|x, y_{&lt;t})</span><span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>τ</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span>p</span><span>(</span><span>x</span><span>)</span><span></span><span>⋅</span><span></span></span><span><span></span><span><span>∏</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span>。取对数，连乘变连加：</p><span><span><span>log⁡πθ(τ)=log⁡p(x)+∑t=1∣y∣log⁡πθ(yt∣x,y&lt;t)\log \pi_\theta(\tau) = \log p(x) + \sum_{t=1}^{|y|} \log \pi_\theta(y_t|x, y_{&lt;t})</span><span><span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>τ</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span>lo<span>g</span></span><span></span><span>p</span><span>(</span><span>x</span><span>)</span><span></span><span>+</span><span></span></span><span><span></span><span><span><span><span><span><span></span><span><span><span>t</span><span>=</span><span>1</span></span></span></span><span><span></span><span><span>∑</span></span></span><span><span></span><span><span><span>∣</span><span>y</span><span>∣</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span></span><p>prompt 是数据集给的，跟模型参数无关，<span><span>∇θlog⁡p(x)=0\nabla_\theta \log p(x) = 0</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span>p</span><span>(</span><span>x</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span>0</span></span></span></span>。所以 (0.4) 里的梯度只剩逐词的项：</p><span><span><span>∇θJ(θ)=E[ ∑t=1∣y∣∇θlog⁡πθ(yt∣x,y&lt;t)⋅R ](0.5)\nabla_\theta J(\theta) = \mathbb{E}\Big[\, \sum_{t=1}^{|y|} \nabla_\theta \log \pi_\theta(y_t|x, y_{&lt;t}) \cdot R \,\Big]
\tag{0.5}</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>J</span><span>(</span><span>θ</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span>E</span><span><span>[</span></span><span></span><span></span><span><span><span><span><span><span></span><span><span><span>t</span><span>=</span><span>1</span></span></span></span><span><span></span><span><span>∑</span></span></span><span><span></span><span><span><span>∣</span><span>y</span><span>∣</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span><span></span><span>⋅</span><span></span></span><span><span></span><span>R</span><span></span><span><span>]</span></span></span><span><span></span><span><span>(</span><span><span>0.5</span></span><span>)</span></span></span></span></span></span></section><section><h3>3.3 因果修剪：过去的奖励可以扔掉<a href="#33-因果修剪过去的奖励可以扔掉"><span>#</span></a></h3><p>先看一个具体的”功劳分配”问题。假设模型生成 3 个词的回答 A、B、C，并且（先假设）每一步都有即时奖励：第 1 步选了 A 拿 2 分，第 2 步选了 B 拿 3 分，第 3 步选了 C 拿 5 分，总分 10。</p><p>按式 (0.5)，A、B、C 三个词的梯度全都乘总分 10。但逐个检查”该乘多少”，会发现配额不对：</p>

<table><thead><tr><th>词</th><th>它的选择能影响什么</th><th>该乘的分数</th></tr></thead><tbody><tr><td>A</td><td>影响后面的一切</td><td>10（2+3+5）✓</td></tr><tr><td>B</td><td>影响第 2 步及之后</td><td>8（3+5），<strong>多算了 2</strong></td></tr><tr><td>C</td><td>只影响第 3 步</td><td>5，<strong>多算了 5</strong></td></tr></tbody></table><p>原因就是时间上的因果：轮到选 C 时，前两步的 2+3=5 分<strong>已经定死了</strong>——C 选什么词都改变不了它们。把不属于 C 的分数算到 C 头上，是错误归因。</p><p><strong>为什么多算的部分可以放心扔掉？</strong> 看选 C 那一步：给定前缀（A、B 已生成），过去的奖励 r₁+r₂ = 5 是一个<strong>定值</strong>。而下一节的引理会说：任何”不偷看当前动作”的定值，乘上当前动作的 <span><span>∇θlog⁡\nabla_\theta \log</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span></span></span></span>，<strong>期望为零</strong>。过去的奖励恰好就是这种定值——跟 C 选什么无关。写成公式：</p><span><span><span>E[ ∇θlog⁡πθ(yt∣⋅)⋅(r1+⋯+rt−1) ]=0(0.6)\mathbb{E}\big[\, \nabla_\theta \log \pi_\theta(y_t|\cdot) \cdot (r_1 + \cdots + r_{t-1}) \,\big] = 0
\tag{0.6}</span><span><span><span></span><span>E</span><span><span>[</span></span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>⋅</span><span>)</span><span></span><span>⋅</span><span></span></span><span><span></span><span>(</span><span><span>r</span><span><span><span><span><span><span></span><span><span>1</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>+</span><span></span></span><span><span></span><span>⋯</span><span></span><span>+</span><span></span></span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span><span>t</span><span>−</span><span>1</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span><span></span><span><span>]</span></span><span></span><span>=</span><span></span></span><span><span></span><span>0</span></span><span><span></span><span><span>(</span><span><span>0.6</span></span><span>)</span></span></span></span></span></span><p>所以多乘的部分在期望上贡献为零：留着不改变梯度的期望，只让每次估计上下乱跳（这次采到的回复过去奖励大，下次小）——纯噪声。删掉，期望不变，波动变小。每个词只对”它之后发生的事”负责：</p><span><span><span>∇θJ(θ)=E[ ∑t=1∣y∣∇θlog⁡πθ(yt∣⋅)⋅R^t ],R^t=rt+rt+1+⋯+r∣y∣(0.7)\nabla_\theta J(\theta) = \mathbb{E}\Big[\, \sum_{t=1}^{|y|} \nabla_\theta \log \pi_\theta(y_t|\cdot) \cdot \hat{R}_t \,\Big], \qquad \hat{R}_t = r_t + r_{t+1} + \cdots + r_{|y|}
\tag{0.7}</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>J</span><span>(</span><span>θ</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span>E</span><span><span>[</span></span><span></span><span></span><span><span><span><span><span><span></span><span><span><span>t</span><span>=</span><span>1</span></span></span></span><span><span></span><span><span>∑</span></span></span><span><span></span><span><span><span>∣</span><span>y</span><span>∣</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>⋅</span><span>)</span><span></span><span>⋅</span><span></span></span><span><span></span><span><span><span><span><span><span><span></span><span>R</span></span><span><span></span><span><span>^</span></span></span></span></span></span></span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span><span>]</span></span><span>,</span><span></span><span></span><span><span><span><span><span><span><span></span><span>R</span></span><span><span></span><span><span>^</span></span></span></span></span></span></span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>=</span><span></span></span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>+</span><span></span></span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span><span>t</span><span>+</span><span>1</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>+</span><span></span></span><span><span></span><span>⋯</span><span></span><span>+</span><span></span></span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span><span>∣</span><span>y</span><span>∣</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span><span><span></span><span><span>(</span><span><span>0.7</span></span><span>)</span></span></span></span></span></span><p><span><span>R^t\hat{R}_t</span><span><span><span></span><span><span><span><span><span><span><span></span><span>R</span></span><span><span></span><span><span>^</span></span></span></span></span></span></span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 叫 <strong>reward-to-go</strong>，“从现在往后还能拿到的分”。上面例子里：A 乘 10、B 乘 8、C 乘 5。</p><p>式 (0.7) 就是 <strong>REINFORCE</strong> 算法：采样一批回复，对每个 token 沿”提高它生成概率”的方向走一步，步长正比于它身后的总奖励。</p><p><strong>LLM 场景的一个特例</strong>：实际 RLHF 里通常整条回复只打一个总分——只有最后一个 token 有分（<span><span>r1=⋯=r∣y∣−1=0r_1 = \cdots = r_{|y|-1} = 0</span><span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span>1</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>=</span><span></span></span><span><span></span><span>⋯</span><span></span><span>=</span><span></span></span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span><span>∣</span><span>y</span><span>∣</span><span>−</span><span>1</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>=</span><span></span></span><span><span></span><span>0</span></span></span></span>，<span><span>r∣y∣=Rr_{|y|} = R</span><span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span><span>∣</span><span>y</span><span>∣</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>=</span><span></span></span><span><span></span><span>R</span></span></span></span>）。这时每个词的 <span><span>R^t\hat{R}_t</span><span><span><span></span><span><span><span><span><span><span><span></span><span>R</span></span><span><span></span><span><span>^</span></span></span></span></span></span></span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 都等于总分 <span><span>RR</span><span><span><span></span><span>R</span></span></span></span>，修剪看起来”没起作用”。它真正生效的场合是每步都有奖励的时候——讲 PPO 时会看到，KL 惩罚会被折进每一步的 reward，那时各词的配额才会真正不同。</p><p>一句话理解式 (0.7)：<span><span>∇θlog⁡πθ(yt∣⋅)\nabla_\theta \log \pi_\theta(y_t|\cdot)</span><span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>⋅</span><span>)</span></span></span></span> 是”把 <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 的概率推高”的方向；乘上 <span><span>R^t\hat{R}_t</span><span><span><span></span><span><span><span><span><span><span><span></span><span>R</span></span><span><span></span><span><span>^</span></span></span></span></span></span></span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 之后——好事迹的 token 被推高，坏事迹的（<span><span>R^t\hat{R}_t</span><span><span><span></span><span><span><span><span><span><span><span></span><span>R</span></span><span><span></span><span><span>^</span></span></span></span></span></span></span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 为负时）被压低。</p><p>但它有个大问题，下一节用数字看。</p><hr /></section></section>
<section><h2>4. 推导②：baseline——为什么能减一个数<a href="#4-推导baseline为什么能减一个数"><span>#</span></a></h2><section><h3>4.1 先看数字：全是正分就是坑<a href="#41-先看数字全是正分就是坑"><span>#</span></a></h3><p>设某个前缀下有三个候选词，当前概率和真实”好坏分”为：</p>

<table><thead><tr><th>token</th><th>概率 <span><span>π\pi</span><span><span><span></span><span>π</span></span></span></span></th><th>好坏分 <span><span>rr</span><span><span><span></span><span>r</span></span></span></span></th></tr></thead><tbody><tr><td>a</td><td>0.7</td><td>10</td></tr><tr><td>b</td><td>0.2</td><td>8</td></tr><tr><td>c</td><td>0.1</td><td>6</td></tr></tbody></table><p>这个前缀下的期望分 <span><span>V=0.7×10+0.2×8+0.1×6=9.2V = 0.7 \times 10 + 0.2 \times 8 + 0.1 \times 6 = 9.2</span><span><span><span></span><span>V</span><span></span><span>=</span><span></span></span><span><span></span><span>0.7</span><span></span><span>×</span><span></span></span><span><span></span><span>10</span><span></span><span>+</span><span></span></span><span><span></span><span>0.2</span><span></span><span>×</span><span></span></span><span><span></span><span>8</span><span></span><span>+</span><span></span></span><span><span></span><span>0.1</span><span></span><span>×</span><span></span></span><span><span></span><span>6</span><span></span><span>=</span><span></span></span><span><span></span><span>9.2</span></span></span></span>。</p><p><strong>没有 baseline 的 REINFORCE（单样本）</strong>：采到谁就推高谁。分数全是正的，所以哪怕采到最差的 c（6 分），梯度也在<strong>推高 c</strong>——方向完全错了。期望上没错（好的被推得更高），但单样本的方向噪声极大，收敛慢。</p><p><strong>减去 baseline <span><span>V=9.2V = 9.2</span><span><span><span></span><span>V</span><span></span><span>=</span><span></span></span><span><span></span><span>9.2</span></span></span></span> 之后</strong>：每个单样本的梯度方向都对了——</p>

<table><thead><tr><th>采到</th><th>优势 <span><span>r−Vr - V</span><span><span><span></span><span>r</span><span></span><span>−</span><span></span></span><span><span></span><span>V</span></span></span></span></th><th>单样本梯度的方向</th></tr></thead><tbody><tr><td>a（10 分）</td><td><span><span>+0.8+0.8</span><span><span><span></span><span>+</span><span>0.8</span></span></span></span></td><td>推高 a ✓</td></tr><tr><td>b（8 分）</td><td><span><span>−1.2-1.2</span><span><span><span></span><span>−</span><span>1.2</span></span></span></span></td><td>压低 b ✓（低于期望就该压）</td></tr><tr><td>c（6 分）</td><td><span><span>−3.2-3.2</span><span><span><span></span><span>−</span><span>3.2</span></span></span></span></td><td>压低 c ✓</td></tr></tbody></table><p><strong>每一步都朝正确方向走</strong>，方差骤降。这就是”优势”的含义：不是”绝对好不好”，而是”<strong>比期望好不好</strong>”。</p></section><section><h3>4.2 三行证明：减一个数不会带偏梯度<a href="#42-三行证明减一个数不会带偏梯度"><span>#</span></a></h3><p>凭空减一个数，会不会把梯度算歪？不会，只要这个数<strong>不依赖当前选的词</strong>。</p><blockquote><p><strong>引理</strong>：对任何不依赖 <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 的函数 <span><span>b(x,y&lt;t)b(x, y_{&lt;t})</span><span><span><span></span><span>b</span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span>——它可以使用前缀的任何信息，唯独不能偷看 <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 本身——都有</p><p><span>\mathbb{E}_{y_t \sim \pi_\theta}\big[\, b \cdot \nabla_\theta \log \pi_\theta(y_t|x, y_{&lt;t}) \,\big] = 0 \tag{0.8}</span></p></blockquote><p>证明只有三行，每一行都有明确的理由：</p><span><span><span>b⋅∑ytπθ(yt∣⋅) ∇θlog⁡πθ(yt∣⋅)  =  b⋅∑yt∇θπθ(yt∣⋅)  =  b⋅∇θ∑ytπθ(yt∣⋅)⏟= 1  =  0b \cdot \sum_{y_t} \pi_\theta(y_t|\cdot)\, \nabla_\theta \log \pi_\theta(y_t|\cdot) \;=\; b \cdot \sum_{y_t} \nabla_\theta \pi_\theta(y_t|\cdot) \;=\; b \cdot \nabla_\theta \underbrace{\sum_{y_t} \pi_\theta(y_t|\cdot)}_{=\,1} \;=\; 0</span><span><span><span></span><span>b</span><span></span><span>⋅</span><span></span></span><span><span></span><span><span><span><span><span><span></span><span><span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span><span><span></span><span><span>∑</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>⋅</span><span>)</span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>lo<span>g</span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>⋅</span><span>)</span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span>b</span><span></span><span>⋅</span><span></span></span><span><span></span><span><span><span><span><span><span></span><span><span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span><span><span></span><span><span>∑</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>⋅</span><span>)</span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span>b</span><span></span><span>⋅</span><span></span></span><span><span></span><span><span>∇</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span><span><span><span><span><span></span><span><span><span>=</span><span></span><span>1</span></span></span></span><span><span></span><span><span><span><span><span><span></span><span><span></span><span></span><span></span></span></span><span><span></span><span><span><span><span><span><span><span></span><span><span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span><span><span></span><span><span>∑</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>⋅</span><span>)</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span>0</span></span></span></span></span><ul>
<li>第一行：<span><span>bb</span><span><span><span></span><span>b</span></span></span></span> 不依赖 <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span>，对 <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 求和时它是常数，可以提到求和号外面；再用 3.2 节的恒等式把 <span><span>π⋅∇log⁡\pi \cdot \nabla \log</span><span><span><span></span><span>π</span><span></span><span>⋅</span><span></span></span><span><span></span><span>∇</span><span></span><span>lo<span>g</span></span></span></span></span> 变回 <span><span>∇π\nabla \pi</span><span><span><span></span><span>∇</span><span>π</span></span></span></span></li>
<li>第二行：有限项求和与求导可以交换</li>
<li>第三行：词表里所有词的概率加起来恒等于 1（概率分布的性质），而 1 的梯度是 0</li>
</ul><p>（顺带一提：3.3 节的式 (0.6) 用的正是这条引理——给定前缀后，过去的奖励已经是定值，当然”不依赖 <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span>“，乘上 <span><span>∇log⁡\nabla \log</span><span><span><span></span><span>∇</span><span></span><span>lo<span>g</span></span></span></span></span> 的期望为零。）</p><p>由引理，减去任何不偷看 <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 的 <span><span>bb</span><span><span><span></span><span>b</span></span></span></span> 都不改变梯度的<strong>期望</strong>，只降低<strong>方差</strong>。数学上还可以证明：让方差最小的 <span><span>bb</span><span><span><span></span><span>b</span></span></span></span>，是下面这个”平均分”。到这里需要给两个量正式起名字：</p><ul>
<li><span><span>V(x,y&lt;t)V(x, y_{&lt;t})</span><span><span><span></span><span>V</span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span>：<strong>还没选词时</strong>的平均分——“看到前缀、还没落笔，各种选法平均能拿多少分”</li>
<li><span><span>Q(x,yt)Q(x, y_t)</span><span><span><span></span><span>Q</span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span>：<strong>选定了某个词之后</strong>的平均分——“这一步选了 <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span>，往后平均能拿多少分”</li>
</ul><p>两者只差一件事：看没看到这一步选了什么。选 <span><span>VV</span><span><span><span></span><span>V</span></span></span></span> 当 baseline，就得到<strong>优势函数</strong>：</p><span><span><span>A(x,yt)  =  Q(x,yt)−V(x,y&lt;t)  =  这一步比期望好多少(0.9)A(x, y_t) \;=\; Q(x, y_t) - V(x, y_{&lt;t}) \;=\; \text{这一步比期望好多少}
\tag{0.9}</span><span><span><span></span><span>A</span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span>Q</span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span><span></span><span>−</span><span></span></span><span><span></span><span>V</span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span><span>这一步比期望好多少</span></span></span><span><span></span><span><span>(</span><span><span>0.9</span></span><span>)</span></span></span></span></span></span><p>回头看 4.1 的数字例子，其实就是这两个量的具体化：表格里”好坏分”一列（选 a 拿 10、选 b 拿 8、选 c 拿 6）扮演的正是 <span><span>QQ</span><span><span><span></span><span>Q</span></span></span></span> 的角色，期望分 9.2 正是 <span><span>VV</span><span><span><span></span><span>V</span></span></span></span>。于是选 a 的优势是 <span><span>10−9.2=+0.810 - 9.2 = +0.8</span><span><span><span></span><span>10</span><span></span><span>−</span><span></span></span><span><span></span><span>9.2</span><span></span><span>=</span><span></span></span><span><span></span><span>+</span><span>0.8</span></span></span></span>，选 c 的优势是 <span><span>6−9.2=−3.26 - 9.2 = -3.2</span><span><span><span></span><span>6</span><span></span><span>−</span><span></span></span><span><span></span><span>9.2</span><span></span><span>=</span><span></span></span><span><span></span><span>−</span><span>3.2</span></span></span></span>。</p><p><strong>Q 不需要单独估，它可以从 V 拼出来。</strong> 想想”选了 <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 之后”发生了什么：拿到这一步的即时奖励 <span><span>rtr_t</span><span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span>；前缀变成新的 <span><span>(x,y≤t)(x, y_{\le t})</span><span><span><span></span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>≤</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span>——又回到了”还没选下一个词”的局面，而那个局面的平均分还是 <span><span>VV</span><span><span><span></span><span>V</span></span></span></span>。所以：</p><span><span><span>Q(x,yt)  =  rt+V(x,y≤t)(0.10)Q(x, y_t) \;=\; r_t + V(x, y_{\le t})
\tag{0.10}</span><span><span><span></span><span>Q</span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>+</span><span></span></span><span><span></span><span>V</span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>≤</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span><span><span></span><span><span>(</span><span><span>0.10</span></span><span>)</span></span></span></span></span></span><p>（折扣因子 <span><span>γ\gamma</span><span><span><span></span><span>γ</span></span></span></span> 的意思是”未来的分打个折”，这里先不引入，不影响任何结论。）</p><p>也就是说：<strong>真正需要估的量只有 V 一个</strong>。有了 V 和每步的即时奖励，Q 按上式随手拼出来，优势也随之有了：</p><span><span><span>A(x,yt)  =  rt+V(新前缀)−V(旧前缀)A(x, y_t) \;=\; r_t + V(\text{新前缀}) - V(\text{旧前缀})</span><span><span><span></span><span>A</span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>+</span><span></span></span><span><span></span><span>V</span><span>(</span><span><span>新前缀</span></span><span>)</span><span></span><span>−</span><span></span></span><span><span></span><span>V</span><span>(</span><span><span>旧前缀</span></span><span>)</span></span></span></span></span><p>4.1 的例子是”选完就结算”的一步特例——没有”之后”，所以 Q 直接就是好坏分本身；真实的多步生成里，Q 要靠式 (0.10) 从 V 递推。</p></section><section><h3>4.3 价值 V 从哪来——三个算法从这里分岔<a href="#43-价值-v-从哪来三个算法从这里分岔"><span>#</span></a></h3><p>到这一步，Q 有了着落（上一节末尾：从 V 拼出来），整个问题只剩一个：<strong><span><span>V(x,y&lt;t)V(x, y_{&lt;t})</span><span><span><span></span><span>V</span><span>(</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span> 怎么得到？</strong> 不同的答案，直接对应不同的算法：</p><ul>
<li><strong>学一个网络来估</strong>：单独训一个模型，输入前缀，输出 <span><span>VV</span><span><span><span></span><span>V</span></span></span></span> 的估计值。这个专门估 <span><span>VV</span><span><span><span></span><span>V</span></span></span></span> 的网络叫 <strong>Critic</strong>（也叫价值模型），规模通常和策略模型一样大——又准又贵。<strong>PPO</strong> 走这条路</li>
<li><strong>用同一道题的多次回答来估</strong>：同一个 prompt 让模型答 <span><span>GG</span><span><span><span></span><span>G</span></span></span></span> 次，组内的平均分就是现成的基准——糙，但一分钱不花。<strong>GRPO</strong> 走这条路</li>
<li><strong>干脆不做 RL</strong>：连 <span><span>VV</span><span><span><span></span><span>V</span></span></span></span> 都不要，把整个问题换一种形式直接算。<strong>DPO</strong> 走这条路</li>
</ul><hr /></section></section>
<section><h2>5. 推导③：重要性采样——旧数据怎么接着用<a href="#5-推导重要性采样旧数据怎么接着用"><span>#</span></a></h2><section><h3>5.1 问题：数据用一次就过期<a href="#51-问题数据用一次就过期"><span>#</span></a></h3><p>REINFORCE 是 on-policy（同策略）的：数据必须由<strong>当前</strong>参数的模型采出来。参数一更新，旧数据就过期了——旧模型采的样本，和新模型的分布对不上。于是采一批、用一次、扔掉，采样时间成了训练的大头。</p></section><section><h3>5.2 恒等式：乘一除一的把戏<a href="#52-恒等式乘一除一的把戏"><span>#</span></a></h3><p>重要性采样回答的问题是：能不能用从分布 <span><span>qq</span><span><span><span></span><span>q</span></span></span></span> 采的样本，去估分布 <span><span>pp</span><span><span><span></span><span>p</span></span></span></span> 下的期望？可以：</p><span><span><span>Ez∼p[f(z)]  =  Ez∼q[ p(z)q(z)⋅f(z) ](0.11)\mathbb{E}_{z \sim p}[f(z)] \;=\; \mathbb{E}_{z \sim q}\Big[\, \frac{p(z)}{q(z)} \cdot f(z) \,\Big]
\tag{0.11}</span><span><span><span></span><span><span>E</span><span><span><span><span><span><span></span><span><span><span>z</span><span>∼</span><span>p</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>[</span><span>f</span><span>(</span><span>z</span><span>)]</span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span><span>E</span><span><span><span><span><span><span></span><span><span><span>z</span><span>∼</span><span>q</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span><span>[</span></span><span></span><span><span></span><span><span><span><span><span><span></span><span><span>q</span><span>(</span><span>z</span><span>)</span></span></span><span><span></span><span></span></span><span><span></span><span><span>p</span><span>(</span><span>z</span><span>)</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span></span><span></span><span>⋅</span><span></span></span><span><span></span><span>f</span><span>(</span><span>z</span><span>)</span><span></span><span><span>]</span></span></span><span><span></span><span><span>(</span><span><span>0.11</span></span><span>)</span></span></span></span></span></span><p>证明只用了一个”乘一除一”：<span><span>p(z)=q(z)⋅p(z)q(z)p(z) = q(z) \cdot \frac{p(z)}{q(z)}</span><span><span><span></span><span>p</span><span>(</span><span>z</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span>q</span><span>(</span><span>z</span><span>)</span><span></span><span>⋅</span><span></span></span><span><span></span><span><span></span><span><span><span><span><span><span></span><span><span><span>q</span><span>(</span><span>z</span><span>)</span></span></span></span><span><span></span><span></span></span><span><span></span><span><span><span>p</span><span>(</span><span>z</span><span>)</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span></span></span></span></span>（乘了 <span><span>qq</span><span><span><span></span><span>q</span></span></span></span> 再除以 <span><span>qq</span><span><span><span></span><span>q</span></span></span></span>，值不变），代进左边的积分：</p><span><span><span>∫p(z)f(z) dz  =  ∫q(z)⋅p(z)q(z)⋅f(z) dz\int p(z) f(z)\, dz \;=\; \int q(z) \cdot \frac{p(z)}{q(z)} \cdot f(z)\, dz</span><span><span><span></span><span>∫</span><span></span><span>p</span><span>(</span><span>z</span><span>)</span><span>f</span><span>(</span><span>z</span><span>)</span><span></span><span>d</span><span>z</span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span>∫</span><span></span><span>q</span><span>(</span><span>z</span><span>)</span><span></span><span>⋅</span><span></span></span><span><span></span><span><span></span><span><span><span><span><span><span></span><span><span>q</span><span>(</span><span>z</span><span>)</span></span></span><span><span></span><span></span></span><span><span></span><span><span>p</span><span>(</span><span>z</span><span>)</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span></span><span></span><span>⋅</span><span></span></span><span><span></span><span>f</span><span>(</span><span>z</span><span>)</span><span></span><span>d</span><span>z</span></span></span></span></span><p>右边恰好是”对 <span><span>qq</span><span><span><span></span><span>q</span></span></span></span> 取期望”的定义。<span><span>■\blacksquare</span><span><span><span></span><span>■</span></span></span></span></p><p>比值 <span><span>p(z)q(z)\frac{p(z)}{q(z)}</span><span><span><span></span><span><span></span><span><span><span><span><span><span></span><span><span><span>q</span><span>(</span><span>z</span><span>)</span></span></span></span><span><span></span><span></span></span><span><span></span><span><span><span>p</span><span>(</span><span>z</span><span>)</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span></span></span></span></span> 是<strong>折算系数</strong>：一个从 <span><span>qq</span><span><span><span></span><span>q</span></span></span></span> 采来的样本，乘上它，就能当成 <span><span>pp</span><span><span><span></span><span>p</span></span></span></span> 的样本用。</p><p>放进 LLM 场景：采样阶段用 <span><span>πold\pi_{\mathrm{old}}</span><span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span><span><span>old</span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 生成回答，训练中小批量更新几轮后参数变成 <span><span>πθ\pi_\theta</span><span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span>。每个 token 位置上的折算系数是</p><span><span><span>wt(θ)  =  πθ(yt∣x,y&lt;t)πold(yt∣x,y&lt;t)(0.12)w_t(\theta) \;=\; \frac{\pi_\theta(y_t|x, y_{&lt;t})}{\pi_{\mathrm{old}}(y_t|x, y_{&lt;t})}
\tag{0.12}</span><span><span><span></span><span><span>w</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>θ</span><span>)</span><span></span><span></span><span>=</span><span></span><span></span></span><span><span></span><span><span></span><span><span><span><span><span><span></span><span><span><span>π</span><span><span><span><span><span><span></span><span><span><span><span>old</span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span><span><span></span><span></span></span><span><span></span><span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>∣</span><span>x</span><span>,</span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span><span></span></span></span><span><span></span><span><span>(</span><span><span>0.12</span></span><span>)</span></span></span></span></span></span><ul>
<li><span><span>wt&gt;1w_t &gt; 1</span><span><span><span></span><span><span>w</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>&gt;</span><span></span></span><span><span></span><span>1</span></span></span></span>：新参数比旧参数更愿意生成这个词</li>
<li><span><span>wt&lt;1w_t &lt; 1</span><span><span><span></span><span><span>w</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>&lt;</span><span></span></span><span><span></span><span>1</span></span></span></span>：新参数在降低这个词的概率</li>
</ul><p>这就是 PPO / GRPO 目标函数里那个 ratio 的来历。</p></section><section><h3>5.3 两个坑：有的没法折算，单个样本折算不准<a href="#53-两个坑有的没法折算单个样本折算不准"><span>#</span></a></h3><p><strong>注意点一：旧模型从不生成的东西，没法折算。</strong> 如果 <span><span>q(z)=0q(z) = 0</span><span><span><span></span><span>q</span><span>(</span><span>z</span><span>)</span><span></span><span>=</span><span></span></span><span><span></span><span>0</span></span></span></span>（旧策略几乎不会生成某个词）而 <span><span>p(z)&gt;0p(z) &gt; 0</span><span><span><span></span><span>p</span><span>(</span><span>z</span><span>)</span><span></span><span>&gt;</span><span></span></span><span><span></span><span>0</span></span></span></span>（新策略想生成它），折算系数 <span><span>p/qp/q</span><span><span><span></span><span>p</span><span>/</span><span>q</span></span></span></span> 会爆炸。折算只对”两边都愿意生成”的样本有意义。</p><p><strong>注意点二：单个样本的折算不可靠。</strong> 式 (0.11) 在期望意义下成立，但 <span><span>pp</span><span><span><span></span><span>p</span></span></span></span> 和 <span><span>qq</span><span><span><span></span><span>q</span></span></span></span> 差得越远，折算系数的波动越大，需要<strong>很多</strong>样本平均才能估准。反过来说：一个位置只有一个样本时，<span><span>wtw_t</span><span><span><span></span><span><span>w</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 更像噪声，起不到修正作用。这一点不是小事——GSPO 论文对 GRPO 的核心批评正是：GRPO 的折算系数按 token 逐个计算，每个位置只有单一样本，数学上根本完成不了分布修正。</p><p>由此还引出一个更基本的问题：折算系数按<strong>每个 token</strong> 算，还是按<strong>整条回答</strong>算？PPO 和 GRPO 按每个 token 算；GSPO 按整条回答算——对式 (0.2) 的连乘取对数再平均。这个差别的后果，讲 GSPO 时展开。</p><hr /></section></section>
<section><h2>6. 一张决策树看全四个算法<a href="#6-一张决策树看全四个算法"><span>#</span></a></h2><p></p><figure><img src="/assets/posts/rl-series-00/decision-tree.svg" alt="四算法决策树" /><figcaption>四算法决策树</figcaption></figure><p></p><p><strong>PPO（2017，OpenAI）</strong>——老实做 RL 的全家桶。四个模型（策略 / 参考 / 奖励 / 价值），GAE（Generalized Advantage Estimation，广义优势估计）算优势，token 级 ratio + clip。它是后面所有算法拿来比较的基准。<strong>死因：太贵</strong>——四模型前向、两个要反向；且价值模型在稀疏奖励的长序列上难训准。</p><p>于是两拨人朝两个不同方向动刀：</p><p><strong>DPO（2023，斯坦福）</strong>——干脆不做 RL。对式 (0.1) 直接求出最优解，把”奖励”反解成”策略与参考模型的概率比”，两步并一步变成偏好对上的二分类损失。只要两个模型。<strong>死因：只能吃离线偏好对</strong>，无法在线探索，复杂推理任务上上限受限。</p><p><strong>GRPO（2024，DeepSeek）</strong>——保留 RL 框架，只砍价值模型。同一 prompt 采样一组回复，组内平均分当 <span><span>VV</span><span><span><span></span><span>V</span></span></span></span>（4.3 节的第二条路），优势直接用组内相对分。DeepSeek-R1 用它配上规则奖励训出了推理能力。<strong>死因：token 级 ratio 抖动</strong>——注意点二的问题被 MoE（Mixture of Experts，混合专家）模型的路由随机性放大，长回复训练会崩溃。</p><p><strong>GSPO（2025，阿里千问）</strong>——把优化粒度从 token 抬到整条序列：序列级 ratio（几何平均 + 长度归一化）+ 序列级裁剪。Qwen3 系列同款，稳训 MoE，不需要任何额外补救技巧。</p><p>注意：DPO 和 GRPO 是 PPO 的<strong>两个不同方向的分支</strong>——一个换掉问题形式（不做 RL），一个换掉估计器（不要价值模型）——不是线性进化的四兄弟。</p><p>把四个算法放到一张表里，全部差异其实只有三个问题：</p>

<table><thead><tr><th>问题</th><th>PPO</th><th>DPO</th><th>GRPO</th><th>GSPO</th></tr></thead><tbody><tr><td>优势怎么估</td><td>学一个 Critic 网络（GAE）</td><td>不估，闭式解绕开</td><td>同题多条回复取组内均值</td><td>同 GRPO</td></tr><tr><td>概率比按什么粒度算</td><td>token 级</td><td>不需要</td><td>token 级</td><td><strong>序列级</strong>（几何平均）</td></tr><tr><td>约束怎么加</td><td>KL 折进 reward + clip</td><td>β 直接进损失（隐式 KL）</td><td>KL 进损失 + clip</td><td>序列级 clip</td></tr></tbody></table><hr /></section>
<section><h2>7. 小结<a href="#7-小结"><span>#</span></a></h2><p>到这儿，手上的东西齐了：</p><ul>
<li><strong>一个方程</strong>：<span><span>max⁡πE[r]−β⋅DKL(π∥πref)\max_\pi \mathbb{E}[r] - \beta \cdot D_{\mathrm{KL}}(\pi \| \pi_{\mathrm{ref}})</span><span><span><span></span><span><span>max</span><span><span><span><span><span><span></span><span><span>π</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span></span><span>E</span><span>[</span><span>r</span><span>]</span><span></span><span>−</span><span></span></span><span><span></span><span>β</span><span></span><span>⋅</span><span></span></span><span><span></span><span><span>D</span><span><span><span><span><span><span></span><span><span><span><span>KL</span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>(</span><span>π</span><span>∥</span><span><span>π</span><span><span><span><span><span><span></span><span><span><span><span>ref</span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span><span>)</span></span></span></span>，后面四个算法优化的都是它</li>
<li><strong>三件工具</strong>：
<ul>
<li>策略梯度 (0.7)：沿”提高好 token 概率”的方向走</li>
<li>优势函数 (0.9)：衡量的不是绝对好坏，是相对期望的好坏</li>
<li>重要性采样 (0.11)：旧数据乘上折算系数继续用，但单个样本的折算不可靠</li>
</ul>
</li>
<li><strong>一张决策树</strong>：四个算法怎么从同一个方程里分出来，各自又死在哪</li>
</ul><hr /></section>
<section><h2>附录：符号表（全系列统一）<a href="#附录符号表全系列统一"><span>#</span></a></h2>

<table><thead><tr><th>符号</th><th>含义</th></tr></thead><tbody><tr><td><span><span>xx</span><span><span><span></span><span>x</span></span></span></span></td><td>prompt</td></tr><tr><td><span><span>yy</span><span><span><span></span><span>y</span></span></span></span>, <span><span>yty_t</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></td><td>完整回复 / 第 <span><span>tt</span><span><span><span></span><span>t</span></span></span></span> 个 token；<span><span>y&lt;ty_{&lt;t}</span><span><span><span></span><span><span>y</span><span><span><span><span><span><span></span><span><span><span>&lt;</span><span>t</span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 表示第 <span><span>tt</span><span><span><span></span><span>t</span></span></span></span> 步之前已生成的词</td></tr><tr><td><span><span>τ=(x,y)\tau = (x, y)</span><span><span><span></span><span>τ</span><span></span><span>=</span><span></span></span><span><span></span><span>(</span><span>x</span><span>,</span><span></span><span>y</span><span>)</span></span></span></span></td><td>轨迹：一次完整回复</td></tr><tr><td><span><span>πθ\pi_\theta</span><span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span>θ</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></td><td>策略模型（被训练的 LLM）</td></tr><tr><td><span><span>πref\pi_{\mathrm{ref}}</span><span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span><span><span>ref</span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></td><td>参考模型（冻结的 SFT）</td></tr><tr><td><span><span>πold\pi_{\mathrm{old}}</span><span><span><span></span><span><span>π</span><span><span><span><span><span><span></span><span><span><span><span>old</span></span></span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></td><td>采样时的旧策略（ratio 的分母）</td></tr><tr><td><span><span>r(x,y)r(x,y)</span><span><span><span></span><span>r</span><span>(</span><span>x</span><span>,</span><span></span><span>y</span><span>)</span></span></span></span></td><td>奖励（RM 打分或规则分）</td></tr><tr><td><span><span>R(τ)R(\tau)</span><span><span><span></span><span>R</span><span>(</span><span>τ</span><span>)</span></span></span></span></td><td>轨迹总分；<span><span>rtr_t</span><span><span><span></span><span><span>r</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> 第 <span><span>tt</span><span><span><span></span><span>t</span></span></span></span> 步即时奖励；<span><span>R^t\hat{R}_t</span><span><span><span></span><span><span><span><span><span><span><span></span><span>R</span></span><span><span></span><span><span>^</span></span></span></span></span></span></span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span> reward-to-go</td></tr><tr><td><span><span>VV</span><span><span><span></span><span>V</span></span></span></span>, <span><span>QQ</span><span><span><span></span><span>Q</span></span></span></span>, <span><span>AA</span><span><span><span></span><span>A</span></span></span></span></td><td>价值函数 / 动作价值 / 优势函数</td></tr><tr><td><span><span>wtw_t</span><span><span><span></span><span><span>w</span><span><span><span><span><span><span></span><span><span>t</span></span></span></span><span>​</span></span><span><span><span></span></span></span></span></span></span></span></span></span></td><td>折算系数（重要性比率 ratio）</td></tr><tr><td><span><span>β\beta</span><span><span><span></span><span>β</span></span></span></span></td><td>KL 约束强度</td></tr><tr><td><span><span>ε\varepsilon</span><span><span><span></span><span>ε</span></span></span></span></td><td>clip 裁剪范围</td></tr><tr><td><span><span>GG</span><span><span><span></span><span>G</span></span></span></span></td><td>组大小（GRPO 每个 prompt 采样的回复数）</td></tr></tbody></table><hr /></section>
<section><h2>参考资料<a href="#参考资料"><span>#</span></a></h2><p><strong>论文</strong></p><ol>
<li>Ouyang et al., 2022. <em>Training language models to follow instructions with human feedback</em>.（InstructGPT 三阶段流程、RLHF 目标方程出处，对应本篇第 1 节） <a href="https://arxiv.org/abs/2203.02155" target="_blank">https://arxiv.org/abs/2203.02155</a></li>
<li>Williams, 1992. <em>Simple statistical gradient-following algorithms for connectionist reinforcement learning</em>.（REINFORCE 原始论文，对应 3.3 节） <em>Machine Learning</em>, 8&lt;229&gt;–256.</li>
<li>Sutton et al., 2000. <em>Policy gradient methods for reinforcement learning with function approximation</em>.（策略梯度定理，对应 3.2 节） NeurIPS 1999.</li>
<li>Schulman et al., 2017. <em>Proximal policy optimization algorithms</em>.（PPO，第 6 节决策树） <a href="https://arxiv.org/abs/1707.06347" target="_blank">https://arxiv.org/abs/1707.06347</a></li>
<li>Rafailov et al., 2023. <em>Direct preference optimization: Your language model is secretly a reward model</em>.（DPO，第 6 节决策树） <a href="https://arxiv.org/abs/2305.18290" target="_blank">https://arxiv.org/abs/2305.18290</a></li>
<li>Shao et al., 2024. <em>DeepSeekMath: Pushing the limits of mathematical reasoning in open language models</em>.（GRPO 首次提出处，第 6 节决策树） <a href="https://arxiv.org/abs/2402.03300" target="_blank">https://arxiv.org/abs/2402.03300</a></li>
<li>DeepSeek-AI, 2025. <em>DeepSeek-R1: Incentivizing reasoning capability in LLMs via reinforcement learning</em>.（规则奖励与 GRPO 的实际应用，第 6 节） <a href="https://arxiv.org/abs/2501.12948" target="_blank">https://arxiv.org/abs/2501.12948</a></li>
<li>Zheng et al., 2025. <em>Group sequence policy optimization</em>.（GSPO，Qwen 团队；5.3 节”单样本折算不可靠”的完整论证见其第 3 节） <a href="https://arxiv.org/abs/2507.18071" target="_blank">https://arxiv.org/abs/2507.18071</a></li>
</ol><p><strong>网络文章</strong></p><ul>
<li>Hugging Face Blog. <em>A guide to reinforcement learning post-training for LLMs: PPO, DPO, GRPO, and beyond</em>.（四算法关系与 KL 估计器位置差异） <a href="https://huggingface.co/blog/karina-zadorozhny/guide-to-llm-post-training-algorithms" target="_blank">https://huggingface.co/blog/karina-zadorozhny/guide-to-llm-post-training-algorithms</a></li>
<li>Hugging Face Blog. <em>Understanding GRPO: PPO without the critic</em>.（GRPO 目标函数的逐步推导，第 6 节延伸阅读） <a href="https://huggingface.co/blog/garg-aayush/derive-grpo-loss" target="_blank">https://huggingface.co/blog/garg-aayush/derive-grpo-loss</a></li>
</ul><blockquote><p>系列目录：《一个方程的四种解法》—— 篇 0 总览 / 篇 1 PPO / 篇 2 DPO / 篇 3 GRPO / 篇 4 GSPO</p></blockquote></section>]]></content>
    </entry>
    <entry>
      <id>https://acoolfish.site/posts/sram-l1-l2-cache/</id>
      <title type="text">10 分钟了解 SRAM、L1 Cache、L2 Cache</title>
      <published>2026-11-15T00:00:00.000Z</published>
      <updated>2026-11-15T00:00:00.000Z</updated>
      <author><name>ACoolBlog</name></author>
      <link rel="alternate" href="https://acoolfish.site/posts/sram-l1-l2-cache/"/>
      <summary type="text">SRAM、Shared Memory、L1、L2、HBM 到底是什么关系？用一张结构图讲清 GPU 的存储层级。</summary>
      <content type="html"><![CDATA[<blockquote><p>本文只是笔者学习之后的思考，不足为道，如果可以，但愿能给你带来点收获。</p></blockquote>
<section><h4>Q1：SRAM 这个词我觉得好陌生，我之前听的最多是 HBM、Shared Memory、寄存器，它们之间的联系区别是什么？<a href="#q1sram-这个词我觉得好陌生我之前听的最多是-hbmshared-memory寄存器它们之间的联系区别是什么"><span>#</span></a></h4><p><strong>SRAM (Static Random Access Memory)</strong> 是一种半导体存储工艺（静态随机存取存储器），速度快但密度低、贵。</p><p>它是硬件层面上的概念，不同于 HBM、Shared Memory、寄存器这些编程模型中的逻辑抽象。</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>GPU 芯片</span></div></div><div><div><div>2</div></div><div><span>├── SM 0  →  自带一块 SRAM (192 KB) → 这个 SM 内的线程共享 ← 这就是该 SM 的 Shared Memory</span></div></div><div><div><div>3</div></div><div><span>├── SM 1  →  自带一块 SRAM (192 KB) → 这个 SM 内的线程共享</span></div></div><div><div><div>4</div></div><div><span>├── SM 2  →  自带一块 SRAM (192 KB) → ...</span></div></div><div><div><div>5</div></div><div><span>│   ... (A100 有 108 个 SM)</span></div></div><div><div><div>6</div></div><div><span>└── SM 107→  自带一块 SRAM (192 KB)</span></div></div><div><div><div>7</div></div><div><span><span>        </span></span><span>↓</span></div></div><div><div><div>8</div></div><div><span><span>   </span></span><span>所有 SM 共享 L2 Cache (40 MB)</span></div></div><div><div><div>9</div></div><div><span><span>        </span></span><span>↓</span></div></div><div><div><div>10</div></div><div><span><span>   </span></span><span>HBM (80 GB，片外)</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>从这个结构知，每个 SM 内部有一块独立的 SRAM，每 SM 的 SRAM 可配成 shared mem + L1。Shared Memory 是 SM 私有的 SRAM 切片。</p><blockquote><p>A100 默认：<strong>192 KB shared memory + 128 KB L1 cache</strong>（同一块 SRAM 上）。</p></blockquote></section>
<section><h4>Q2：L1 cache 又是什么？有什么用？和其他几个概念的联系是什么？<a href="#q2l1-cache-又是什么有什么用和其他几个概念的联系是什么"><span>#</span></a></h4><p><strong>L1 Cache 和 Shared Memory 物理上是同一块 SRAM 的两个分区</strong>，只是管理权限不同。</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>SM 内部的一块 SRAM (A100: 192 KB shared + 128 KB L1 = 256 KB 总量)</span></div></div><div><div><div>2</div></div><div><span>├── Shared Memory (192 KB)  ← 程序员显式管理</span></div></div><div><div><div>3</div></div><div><span>└── L1 Cache (128 KB)       ← 硬件自动管理</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p><strong>L1 Cache 的实际作用</strong>（有点超纲了，小白可跳过知道是啥就行了）</p><ol>
<li><strong>自动缓存寄存器溢出</strong>：线程寄存器不够用时数据会 spill 到 L1（叫 local memory），比直接去 HBM 快。</li>
<li><strong>自动缓存全局内存读</strong>：同一个 SM 的多个线程读同一地址时，L1 命中可避免重复走 HBM。</li>
<li><strong>间接优化算子</strong>：好的访问模式能让 L1 命中率高，差的模式（如随机跳读）会让 L1 失效，性能掉到 HBM 带宽。</li>
</ol></section>
<section><h4>Q3：L2 cache 是什么？有什么用？和其他几个概念的联系是什么？<a href="#q3l2-cache-是什么有什么用和其他几个概念的联系是什么"><span>#</span></a></h4><p>L2 Cache 也是片上缓存（也就是 SRAM 工艺），但它是<strong>所有 SM 共享</strong>的，用作 HBM 读写的缓冲，由<strong>硬件自动管理</strong>，程序员一般不直接控制。也就是 L2 Cache 相当于 HBM 的”前置缓存”。当 SM 要读 HBM 里的数据时，数据会先被搬到 L2，下次同样的数据再被读到时，就能直接从 L2 拿，不用再走慢吞吞的 HBM。</p><section><h6>L2 Cache 怎么工作<a href="#l2-cache-怎么工作"><span>#</span></a></h6><p>当 SM 要读 HBM 里某个数据时，硬件自动走这条链：</p><ol>
<li>先查 L2：如果数据在 L2 里有副本（命中 hit），直接从 L2 取走（1.5 TB/s，不用去 HBM）。</li>
<li>L2 没命中（miss）：穿透到 HBM 取数据。</li>
<li>取回来的同时：数据会被复制一份留在 L2 里。</li>
<li>下次再读同一块数据：直接命中 L2，省掉一次 HBM 往返。</li>
</ol></section><section><h6>L2 vs SRAM 的关键区别<a href="#l2-vs-sram-的关键区别"><span>#</span></a></h6><p>虽然都是片上缓存，但角色完全不同：</p><ul>
<li><strong>SRAM (Shared Memory)</strong> 是程序员的”工作台”——你明确告诉 GPU 哪些数据要放进来共享、什么时候加载。FlashAttention 的 tile 就是显式塞进 SRAM 的。</li>
<li><strong>L2 Cache</strong> 是硬件的”自动缓存”——你管不了它存什么。但你能利用它的特性：如果连续两个算子读同一块 HBM 数据（比如 <code>QK^T</code> 之后又要读 <code>S</code> 做 softmax），L2 可能让第二次读命中。</li>
</ul></section></section>
<section><h4>图解 L1、L2、SRAM<a href="#图解-l1l2sram"><span>#</span></a></h4><p></p><figure><img src="/assets/posts/sram-l1-l2-cache/sram-l1-l2-diagram.png" alt="图解 L1、L2、SRAM 存储层级" /><figcaption>图解 L1、L2、SRAM 存储层级</figcaption></figure><p></p></section>]]></content>
    </entry>
</feed>